9 月 22 日晚,多范式算子开发实战营邀请联培博士生吴航老师,带来《基于 AI Agent 实现算子的编写、验证与优化》。
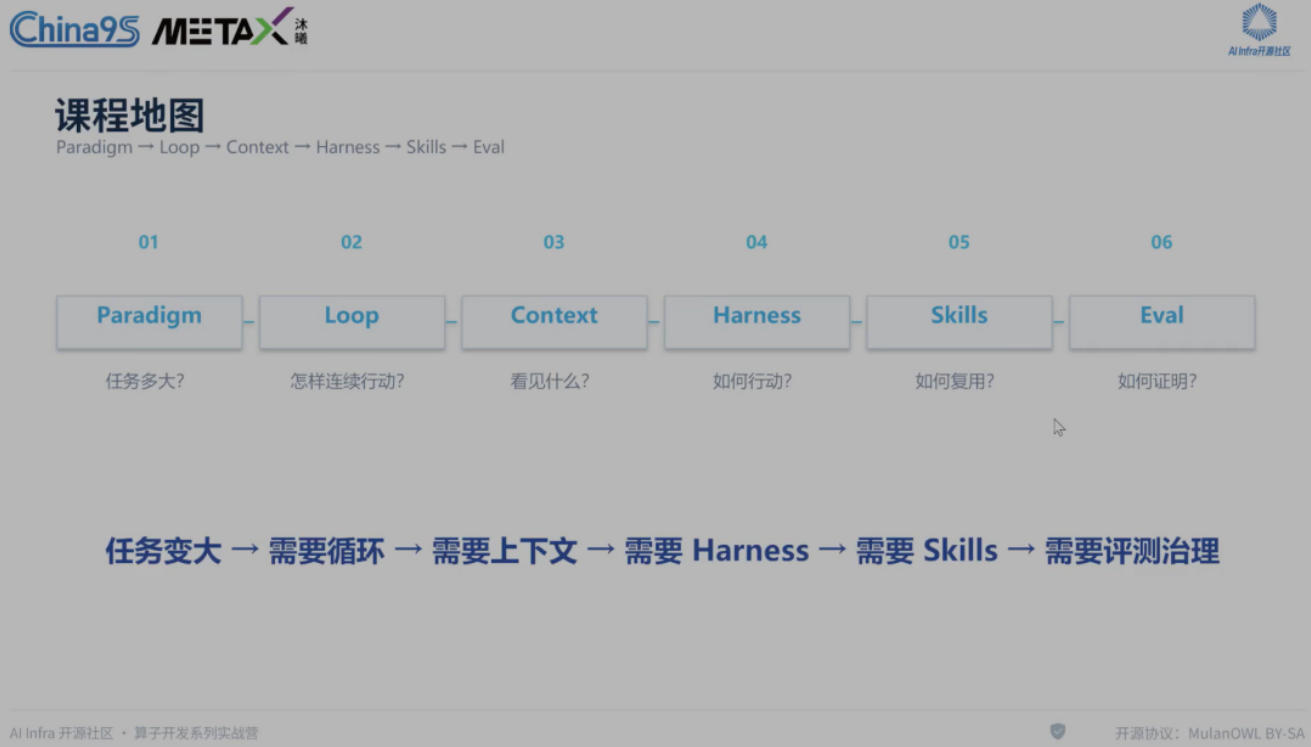
一、AI Coding 的范式演进与任务边界
AI 编程的三个发展阶段
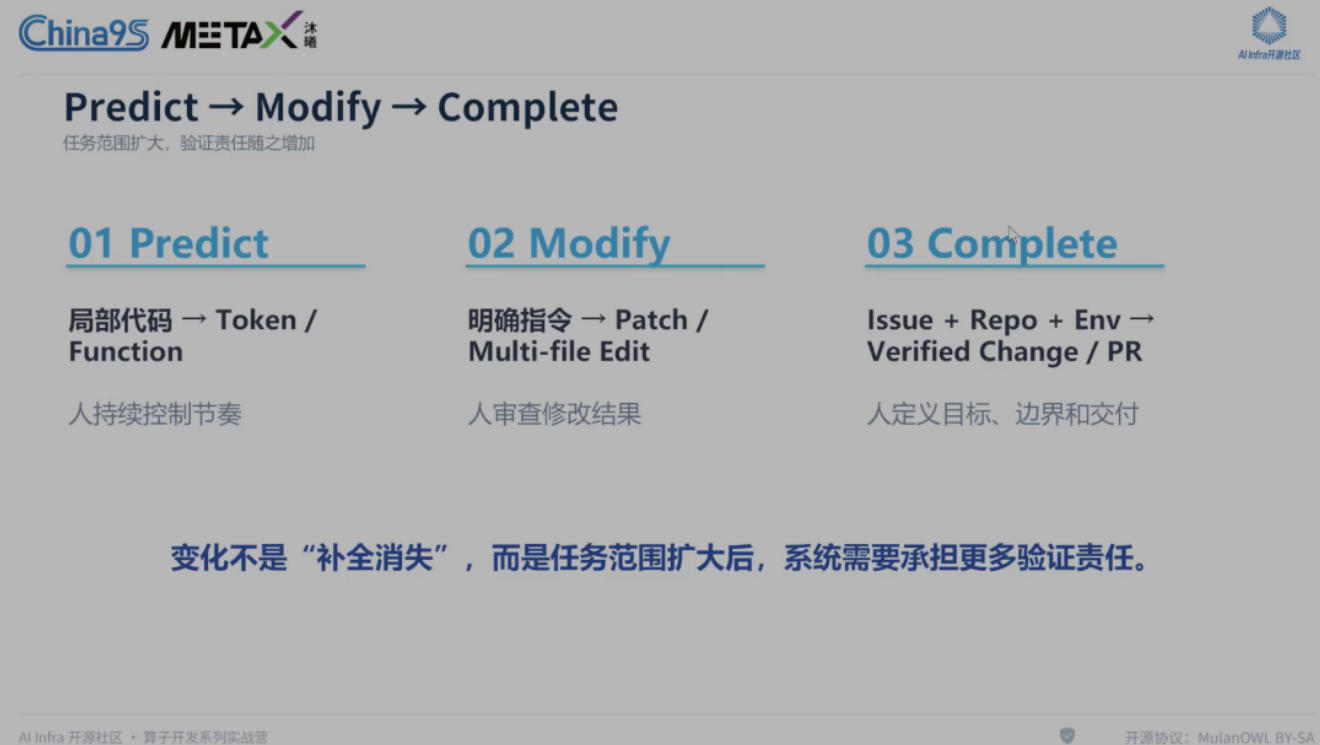
1. Predict(预测):基于上下文预测下一行/片段,工作对象小(Token/表达式级)。
2. Modify(修改):基于自然语言指令修改单/多文件,输出为 Patch。
3. Complete(完成):输入 Issue/仓库/验收条件,输出 Commit/PR/分支,承担验证责任。
4.核心观点:变化不是补全消失,而是任务范围扩大后,系统需承担更多验证责任。
五种 Vibe Coding 工作形态
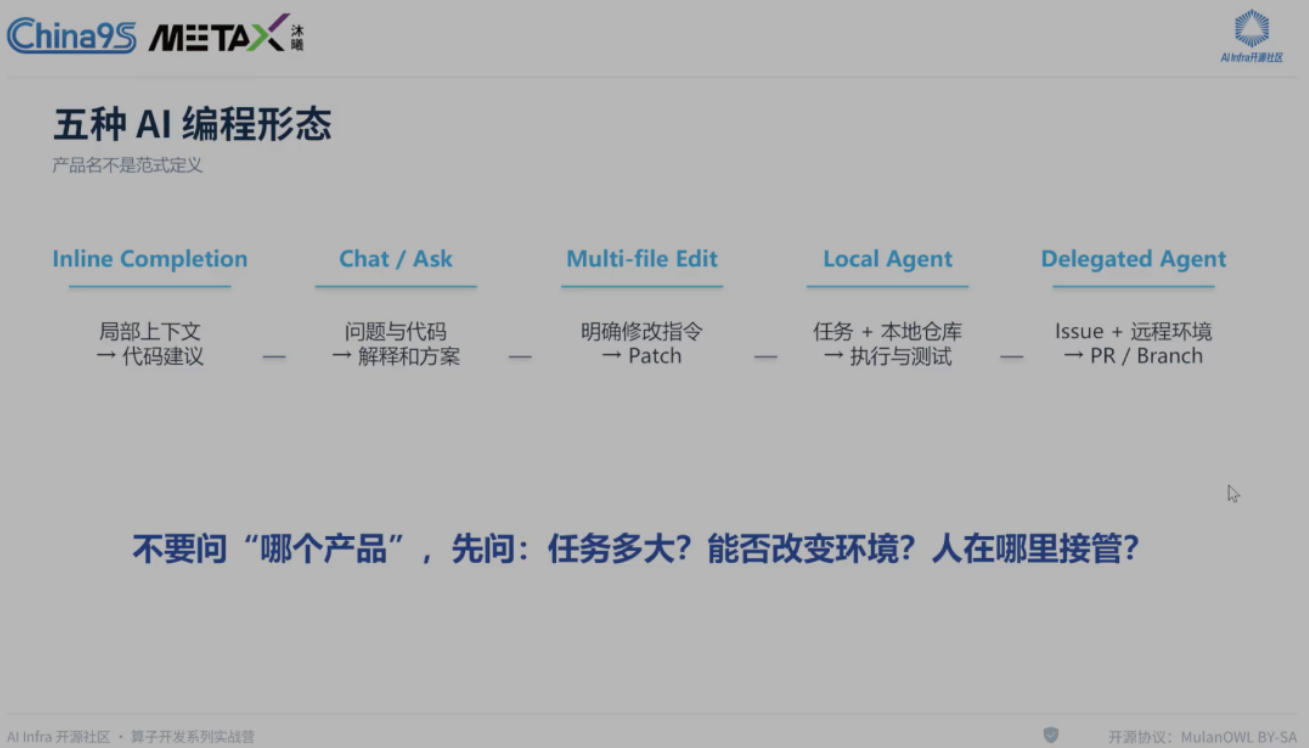
1. Inline Completion:光标级补全,人掌握节奏。
2. Chat/Ask:技术顾问模式,解释与分析,不改真实环境。
3. Multi-file Edit:明确指令下的多文件 Patch 生成。
4. Local Agent:本地仓库扫描、检索、执行命令、测试反馈。
5. Delegated Agent:远程隔离环境后台运行,通过 PR 交付,需明确目标与验收条件。
任务范围 vs 自治程度坐标系
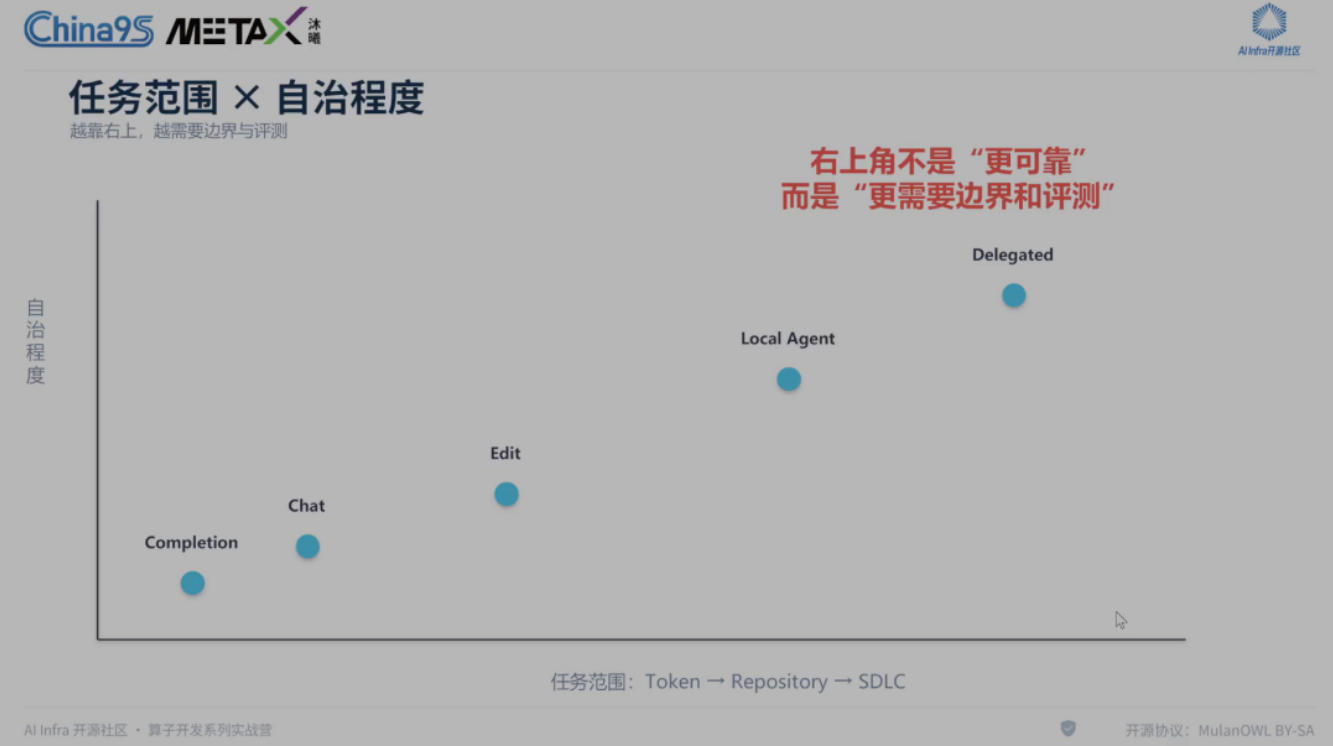
- 左下角:代码补全(任务小、自治低)。
- 右上角:仓库级/后台 Agent(任务大、自治高)。
- ⚠️右上角不代表更先进或更可靠,高自治意味着错误影响范围更大。成熟做法是明确目标、可靠反馈、可控权限。
工程控制点
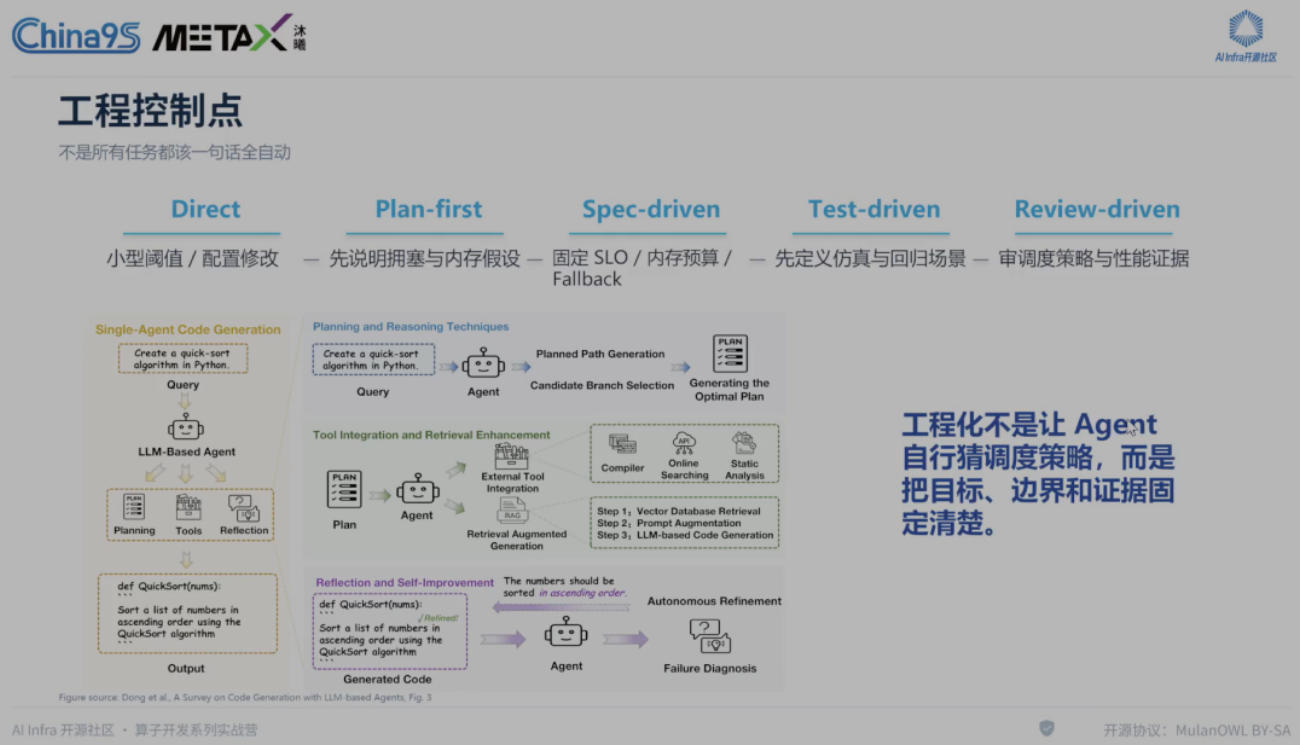
1. Direct:低风险、明确任务(如改阈值)。
2. Plan-First:中等复杂度,先让 Agent 分析瓶颈假设,人确认后再改。
3. Spec-driven:涉及调度/资源边界,固定 SLO、显存预算、Fallback 行为。
4. Test-driven:可明确测试的任务,先定义仿真/回归测试场景。
5. Review-driven:高风险性能优化,人或独立审查 Agent 策略。
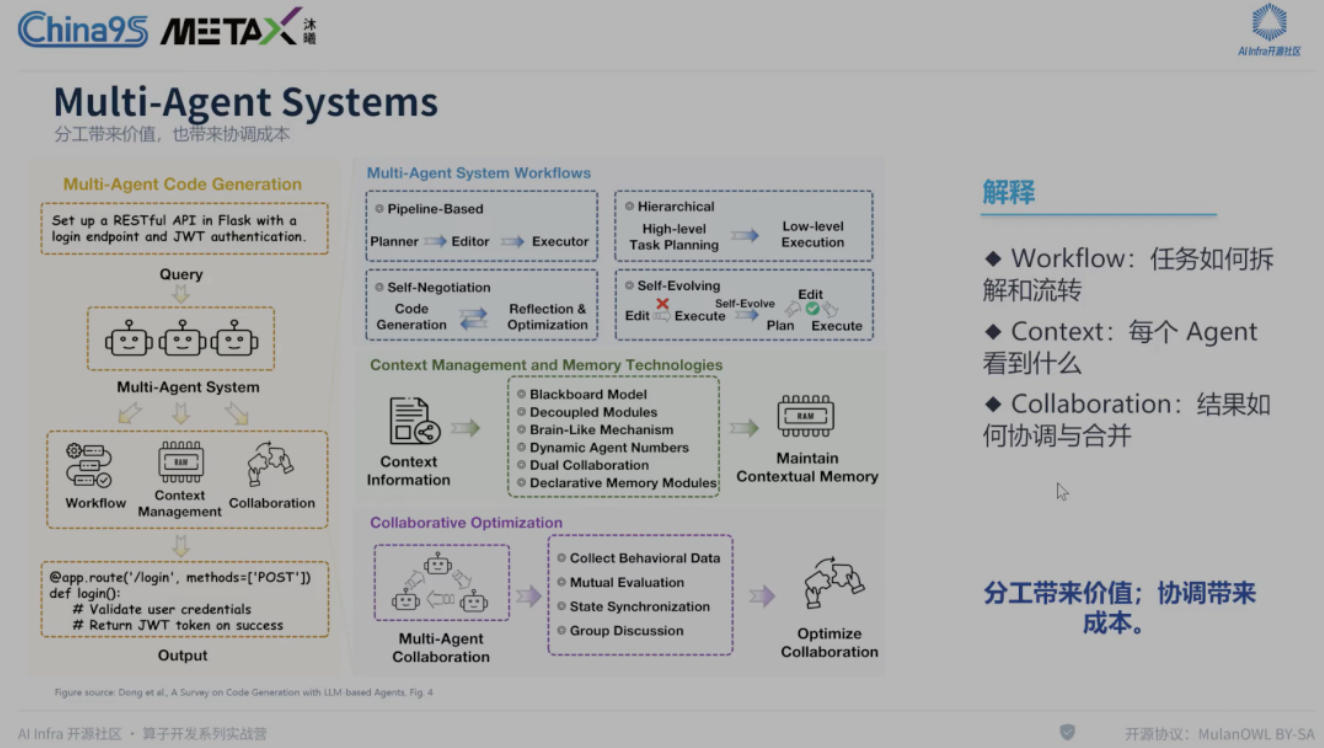
6. Multi-Agent:分工带来价值,但协调带来成本。适用于边界清晰、可独立验证的任务。
二、Agent 系统架构与核心组件
模型 ≠ Agent
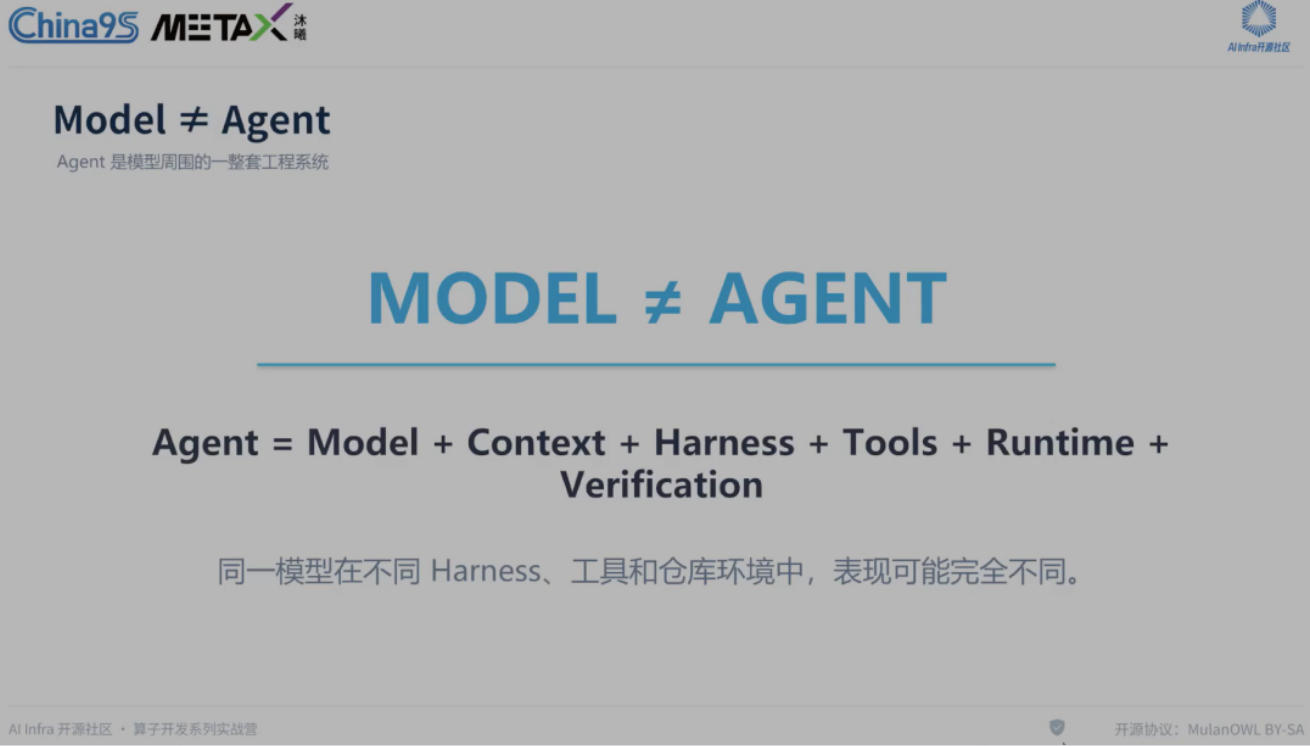
1. Code Model 的最低必要原理:
- 预测下一批 Token
- Fill-in-the-Middle
- 结构化工具调用
2. 三角色分工:
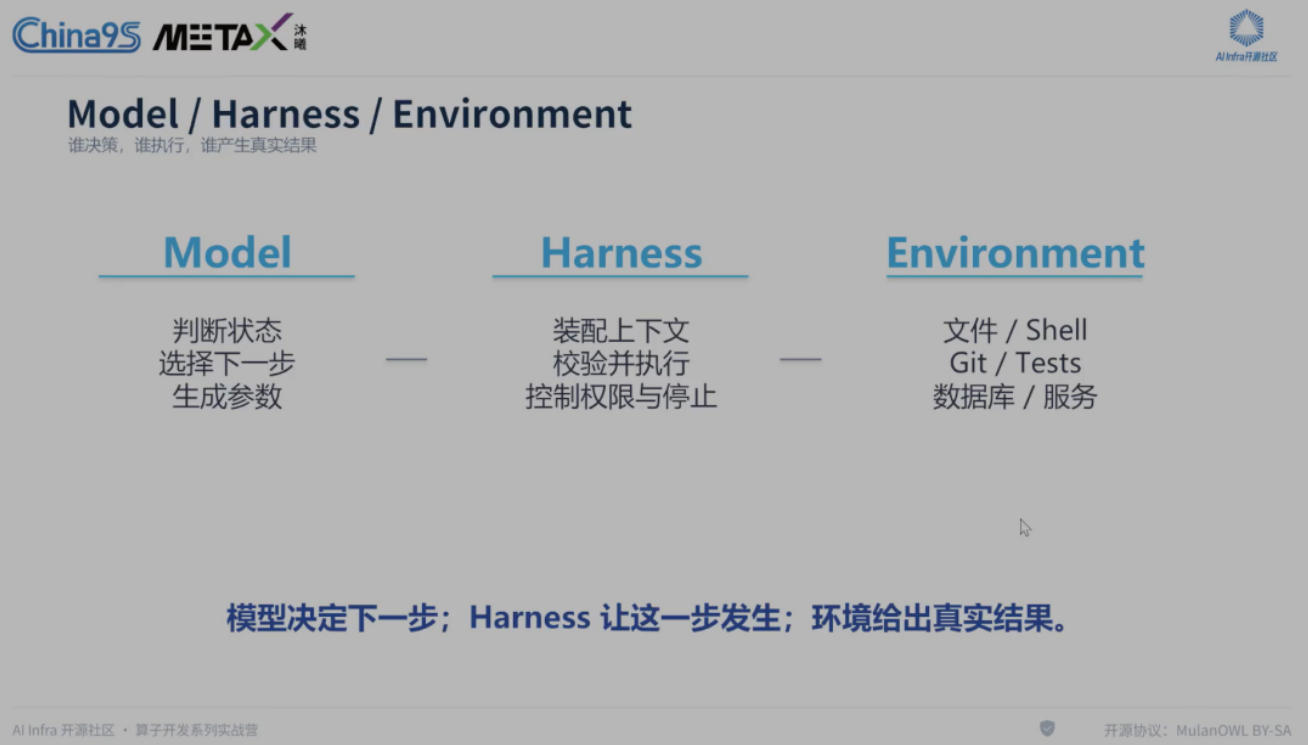
- Model:阅读信息、判断现状、选择下一步、生成参数。
- Harness:装配上下文、校验参数、发起执行、记录状态、控制权限。
- Environment:文件系统、Shell、Git、Benchmark、GPU 等真实反馈源。
Coding Agent Loop
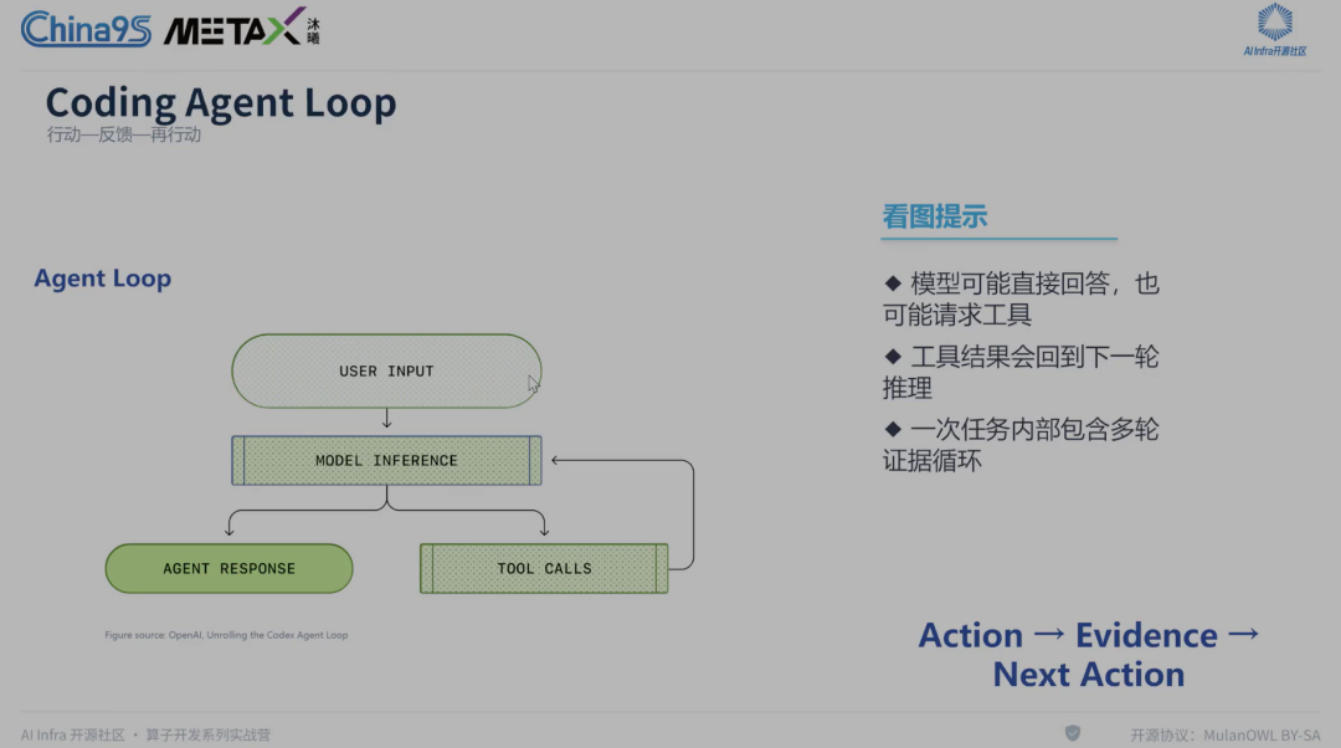
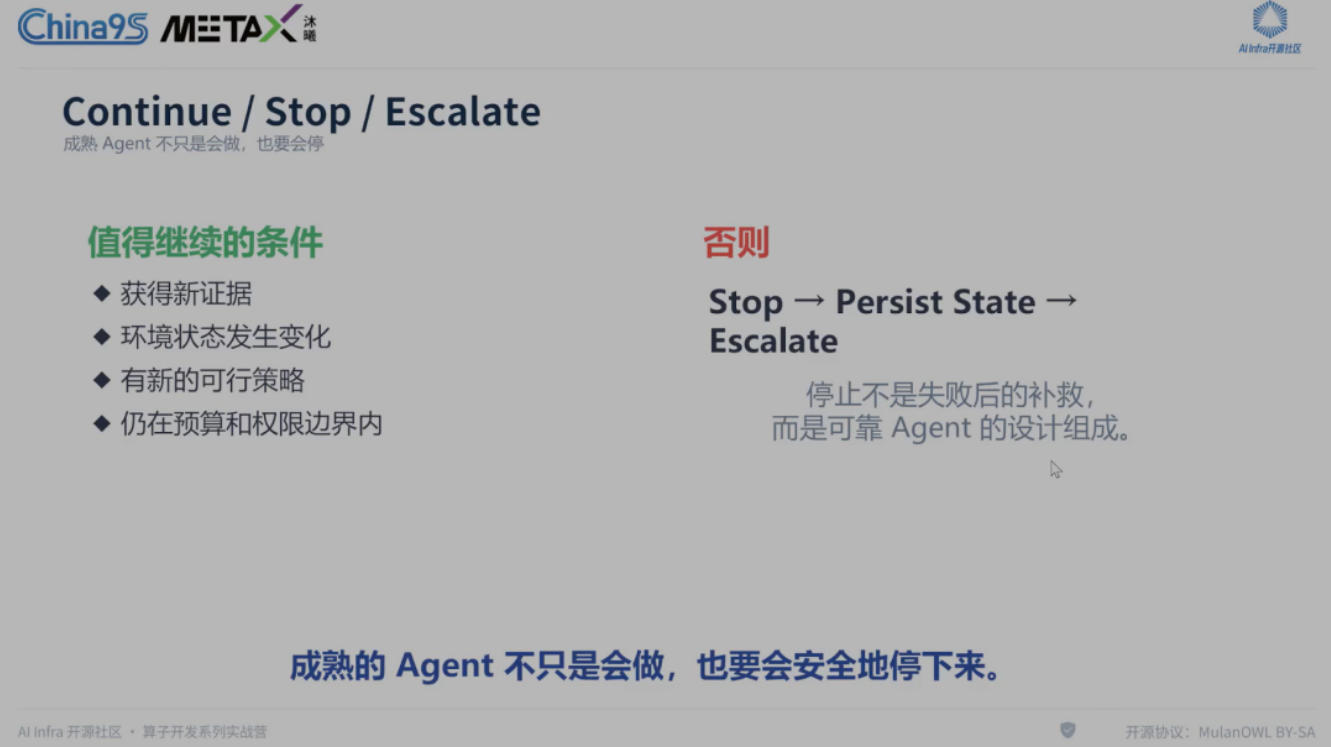
- 循环逻辑:观察状态 → 执行动作 → 获取反馈 → 修正决策。
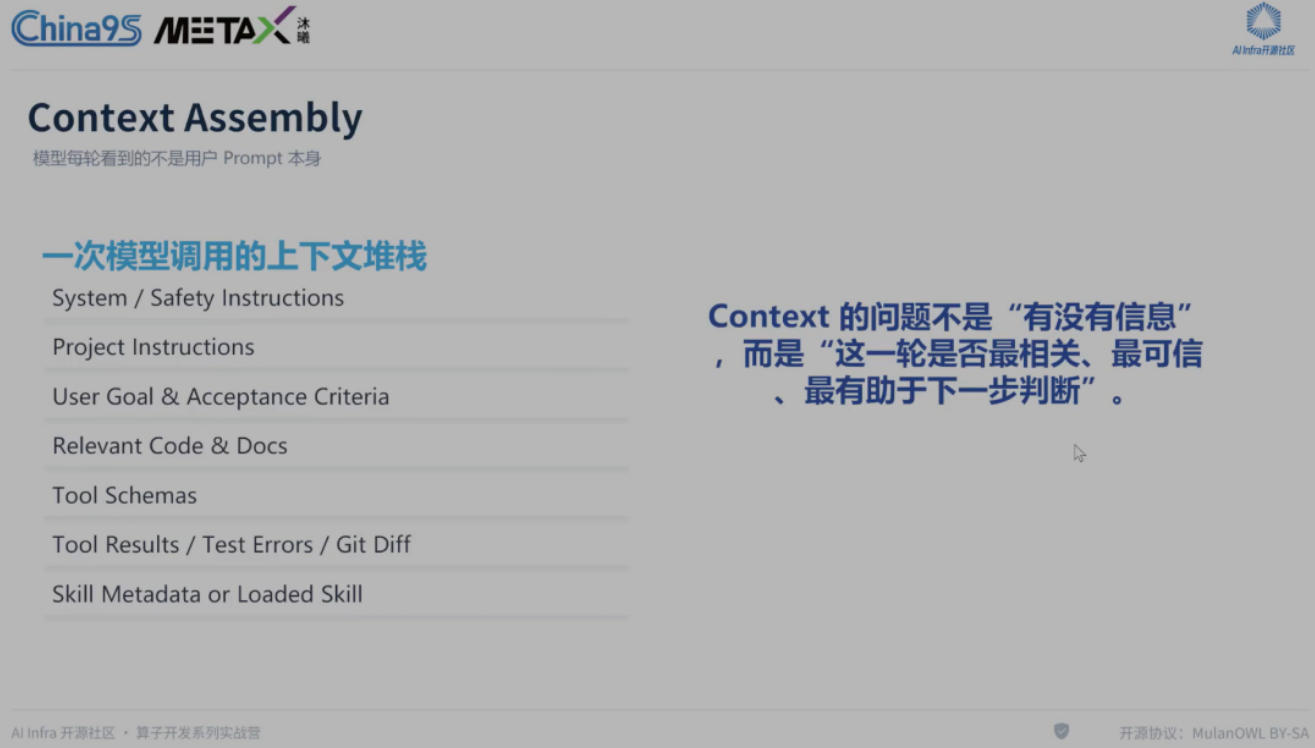
1. Context Assembly
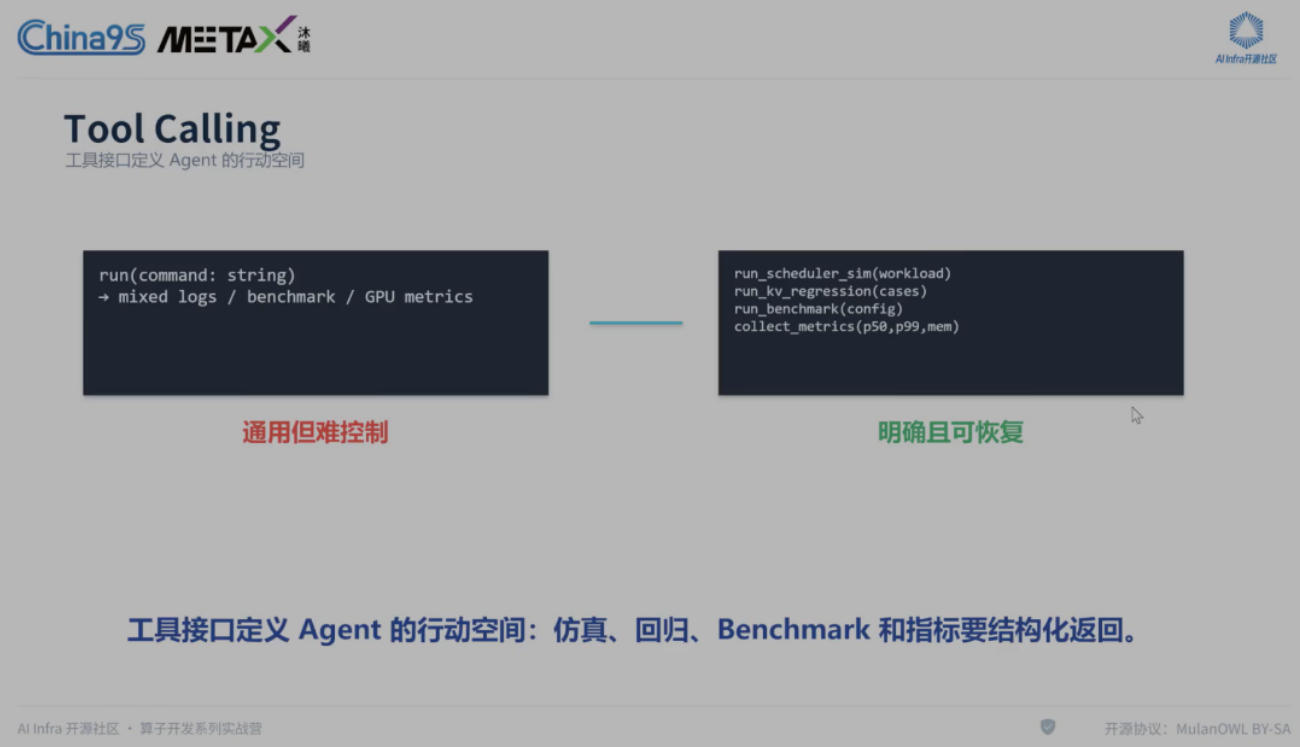
2. Tool Calling
六层系统架构
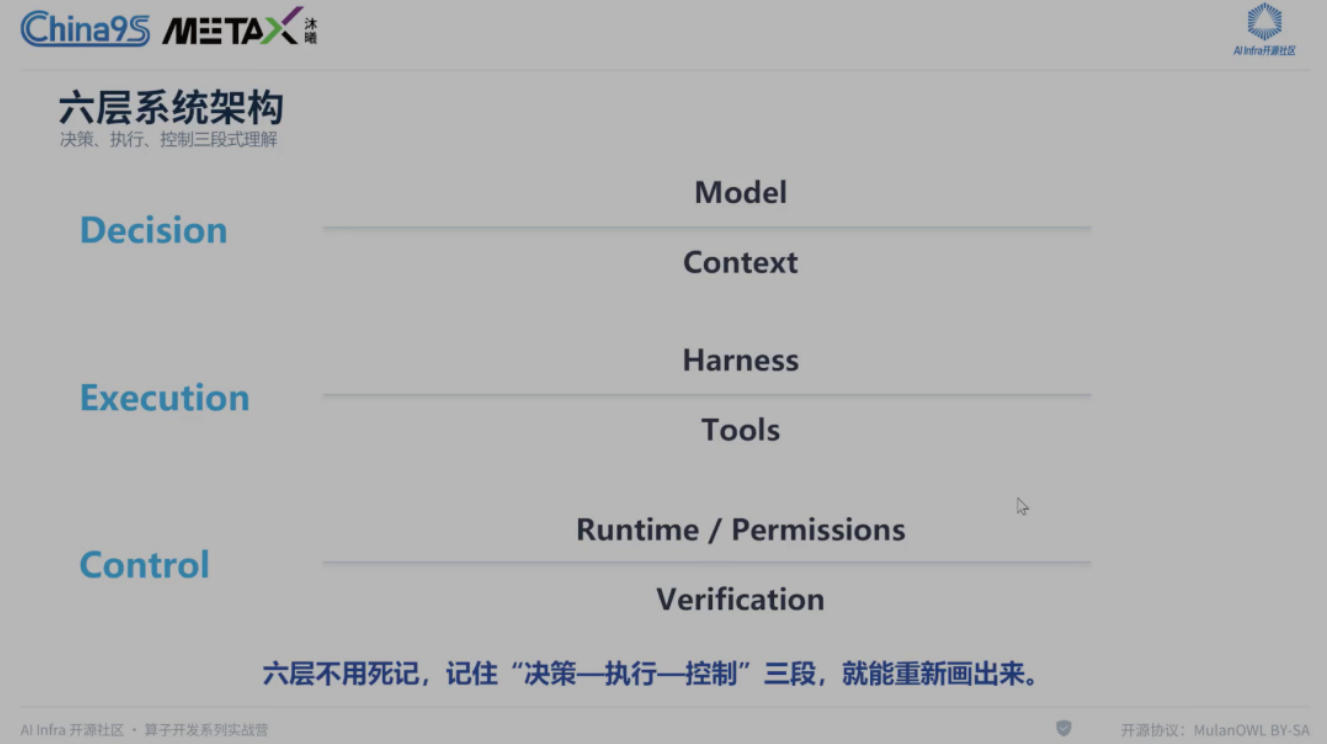
1. Model & Context:谁做决定?
2. Harness & Tools:决定如何变成动作?
3. Runtime & Verification:动作如何被限制和验证?
4. 应用:当 AI 表现不佳时,逐层排查问题所在。
三、Context Engineering 与 Harness Engineering
Context Engineering(上下文工程)
1. Prompt ≠ Context:Prompt 关注“怎么说”,Context 关注“让模型看见什么”。
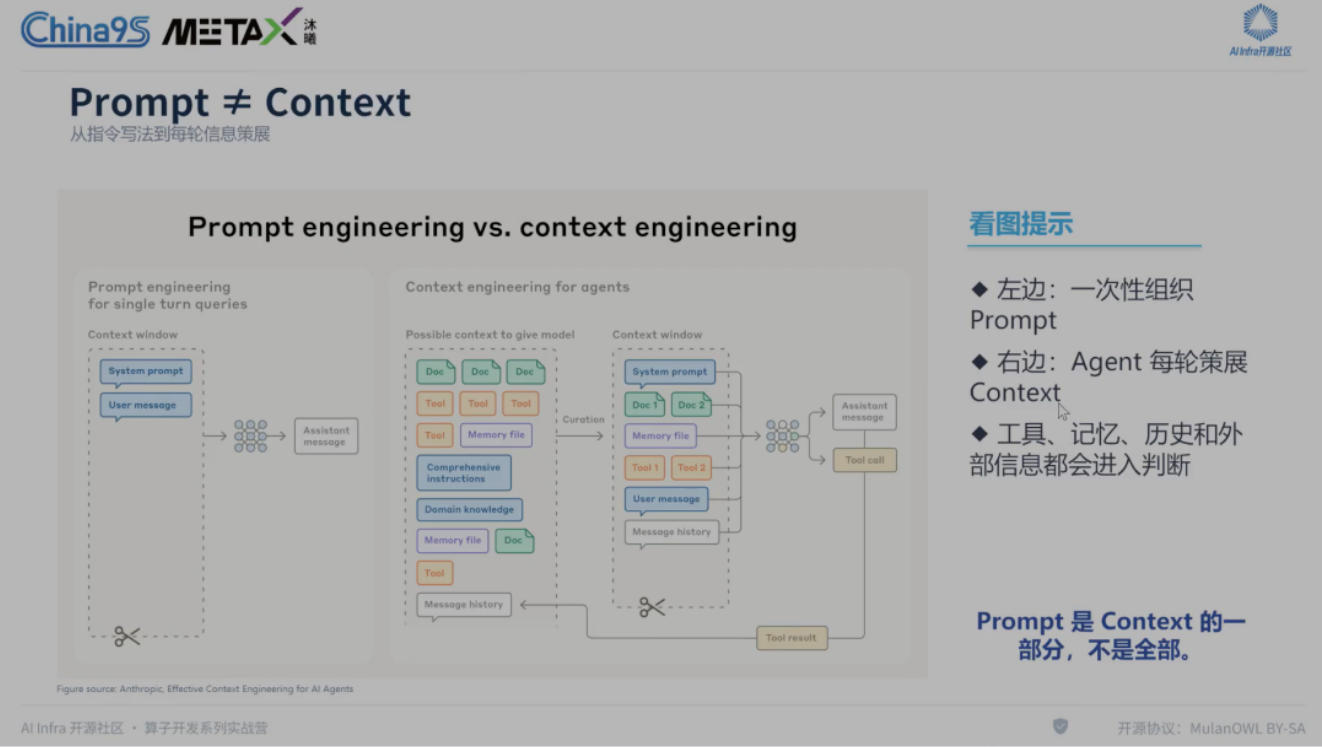
2. 五类上下文:
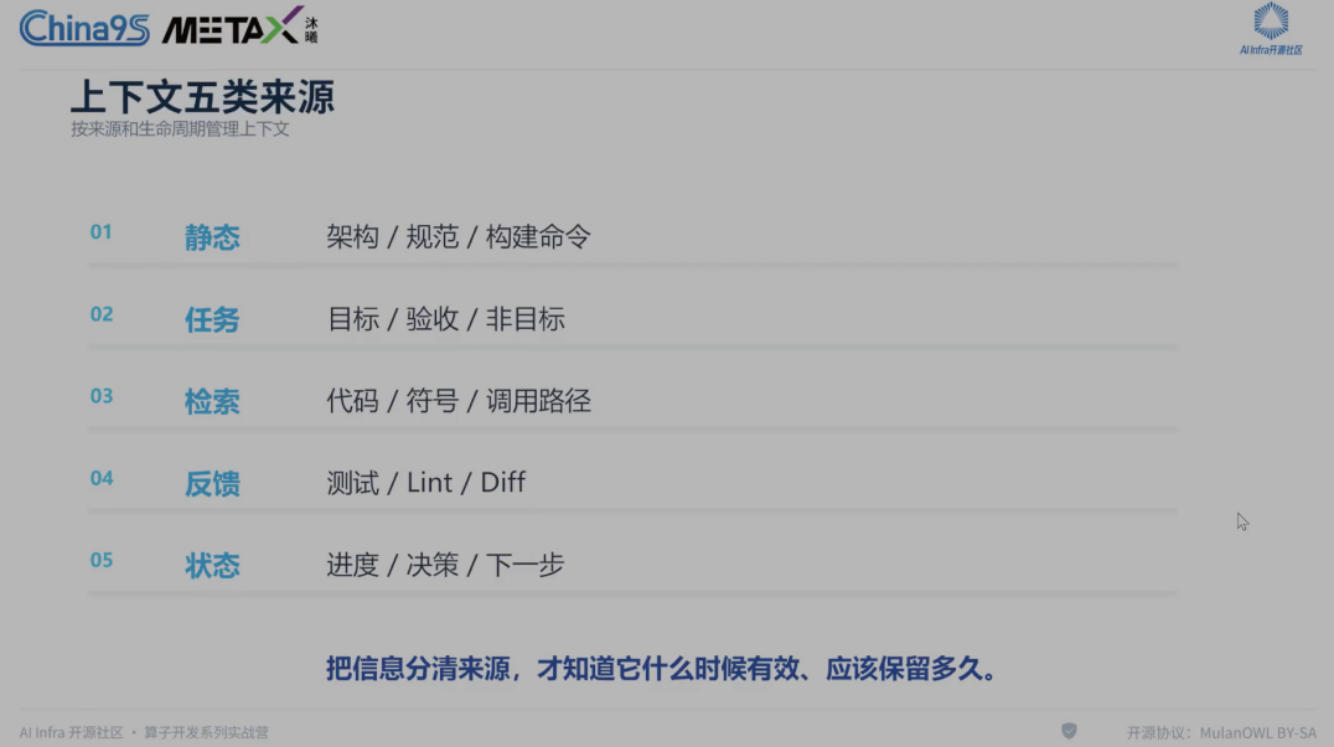
3. 生命周期:Discover → Select → Load → Use → Compress → Persist。
⚠️ Select 比 Discover 更重要;长任务需 Compaction(压缩),保留关键决策与证据,移除重复低价值内容;动态摘要 ≠ 事实本身。
Harness Engineering
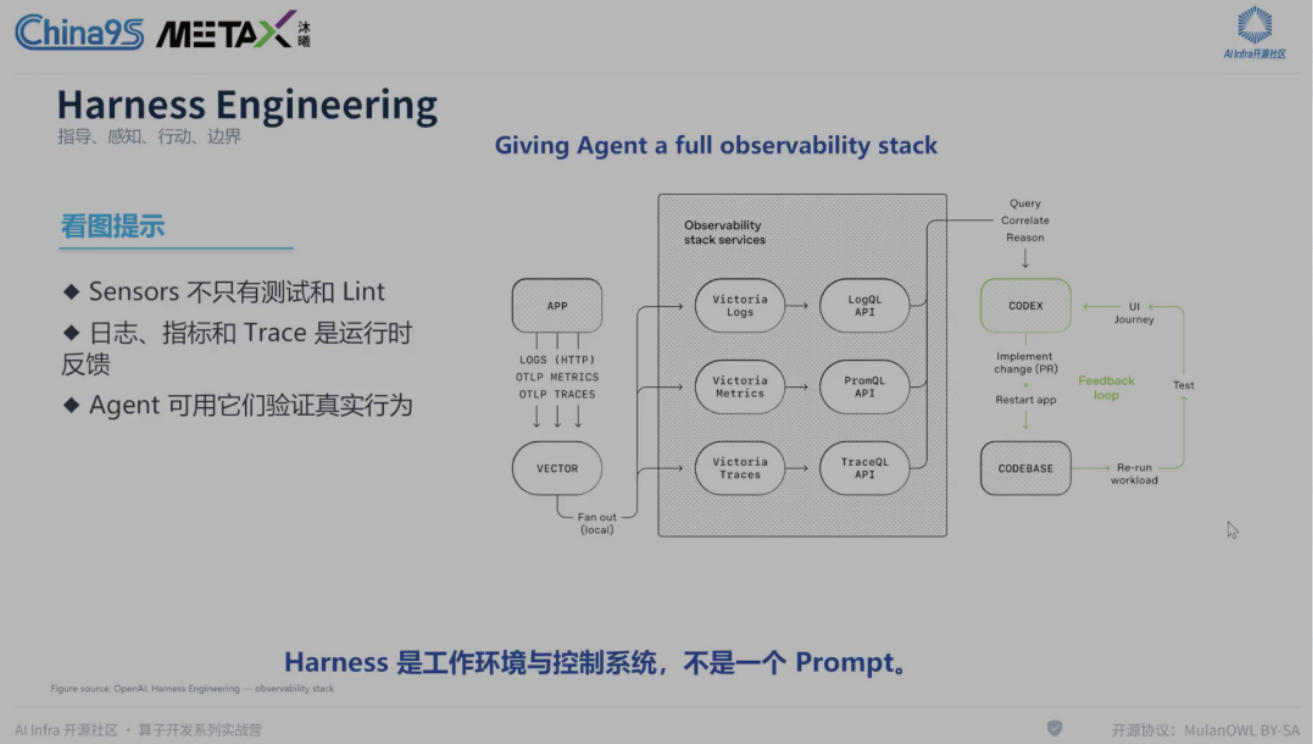
1. 四大组成:指导、感知、行动工具、边界。
2. 工具设计原则:不是越通用越好,而是明确、结构化、边界清晰。
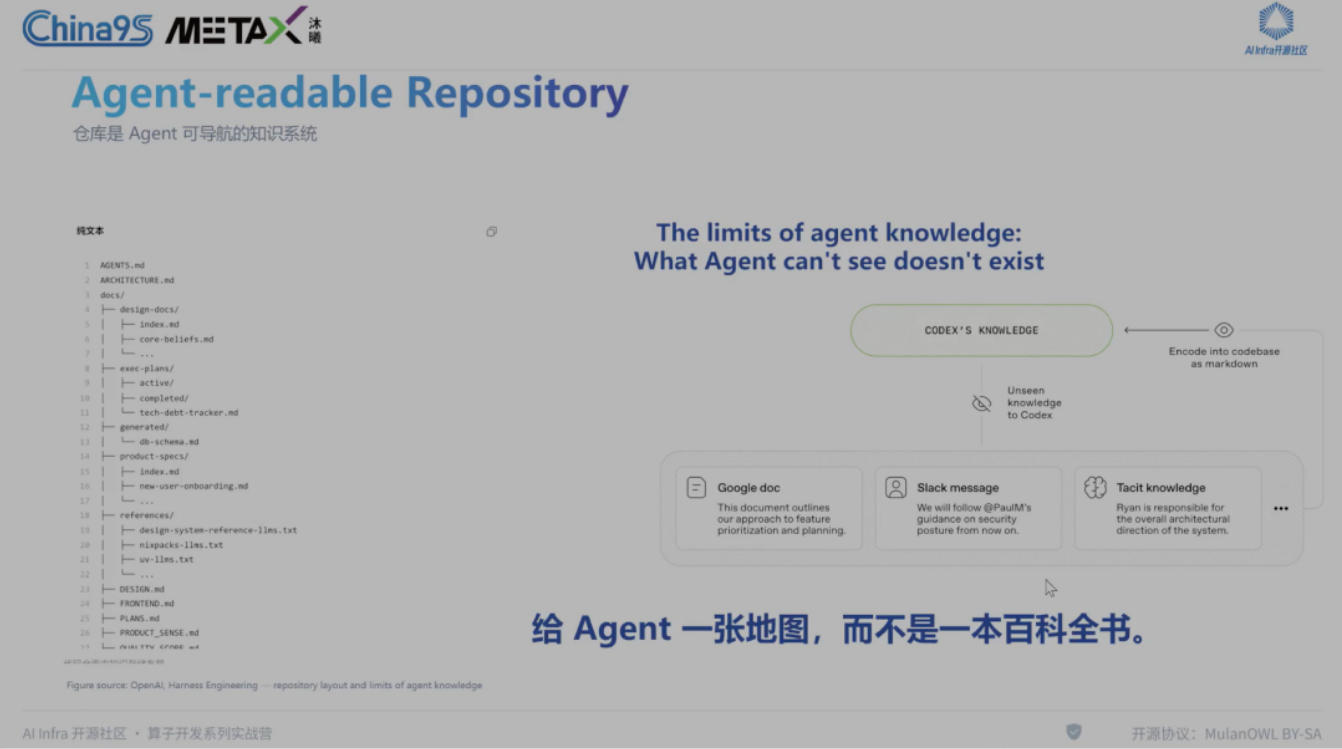
3. 仓库即工作环境:给 Agent “地图”而非“百科全书”;信息需可发现、可导航、可版本化。
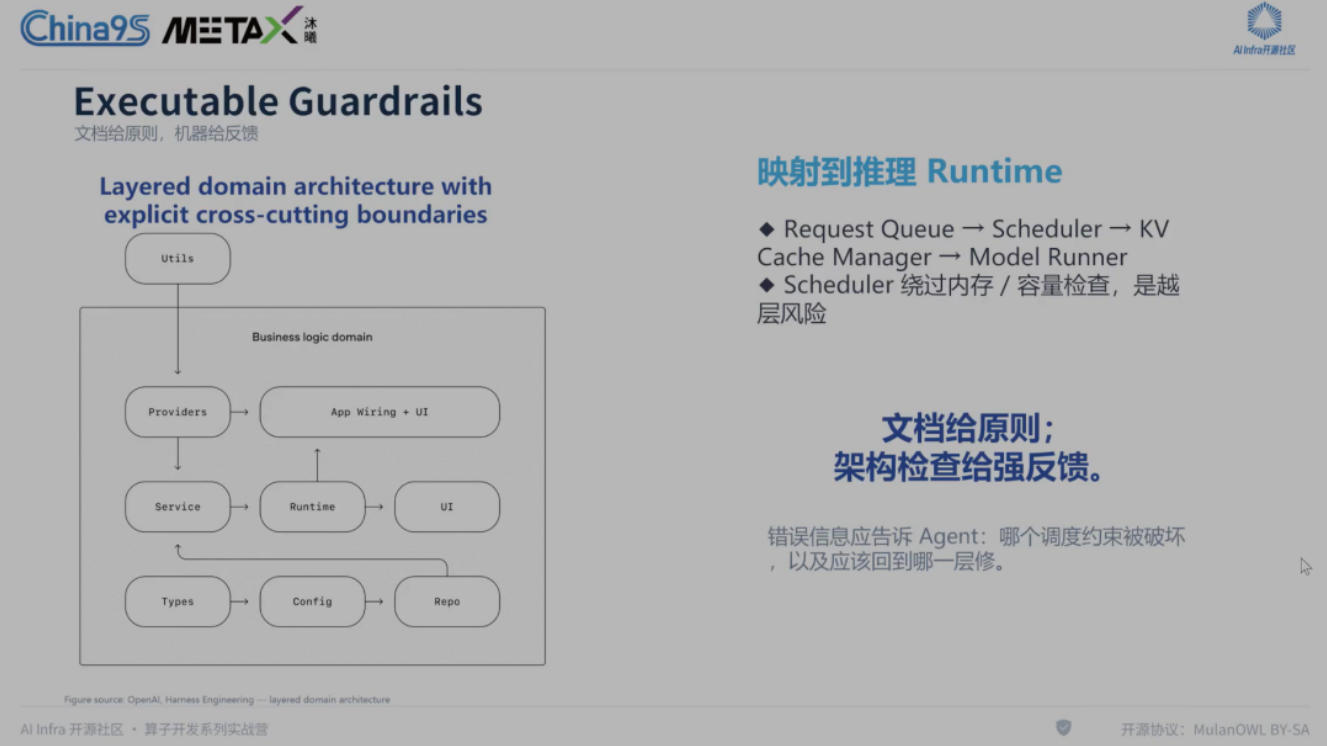
4. Executable Guardrails:将文档规则转化为可执行的检查/测试,产生明确失败信号,比纯文本原则更可靠。
Agent Skill
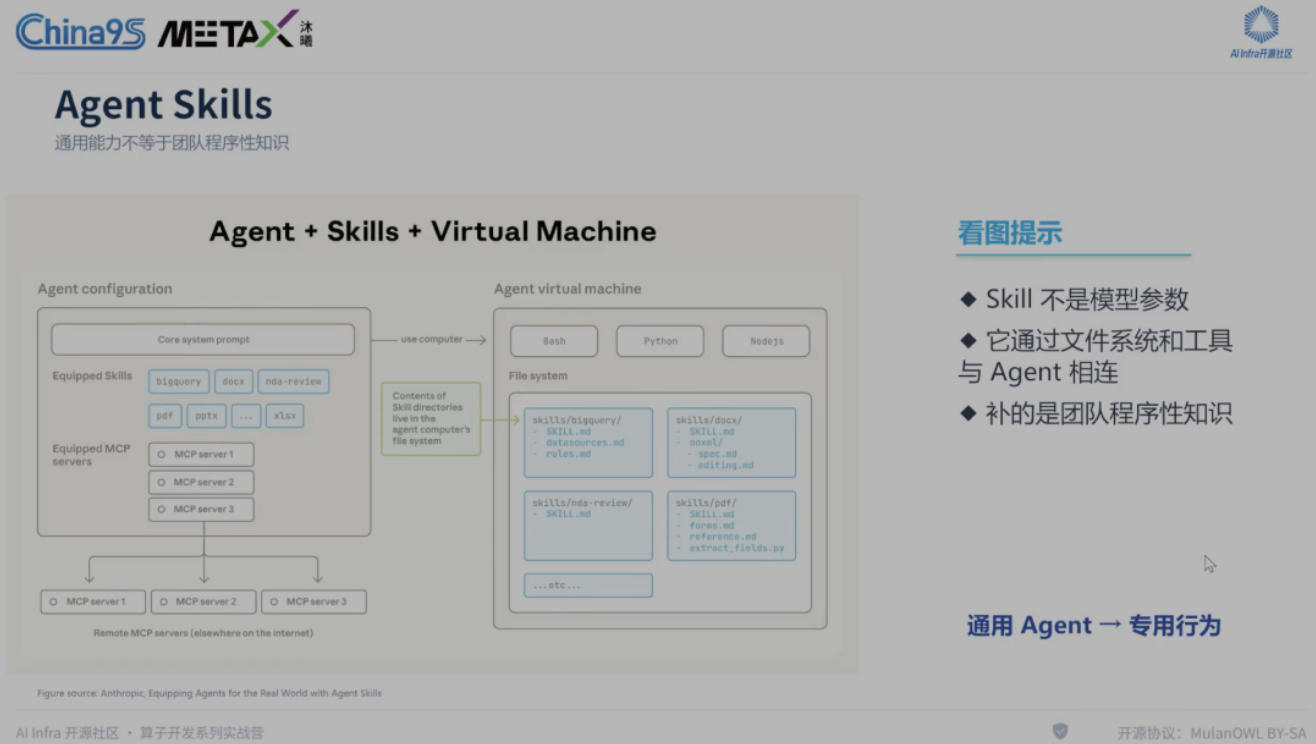
1. 定义:打包的操作方法、参考资料、验证脚本,是可版本化、可测试的团队资产。
2. 三要素:什么时候用?怎么做?怎么证明做对了?
3. 渐进式披露:名称/描述 → Skill.md → 具体执行文件,避免一次性占满上下文。
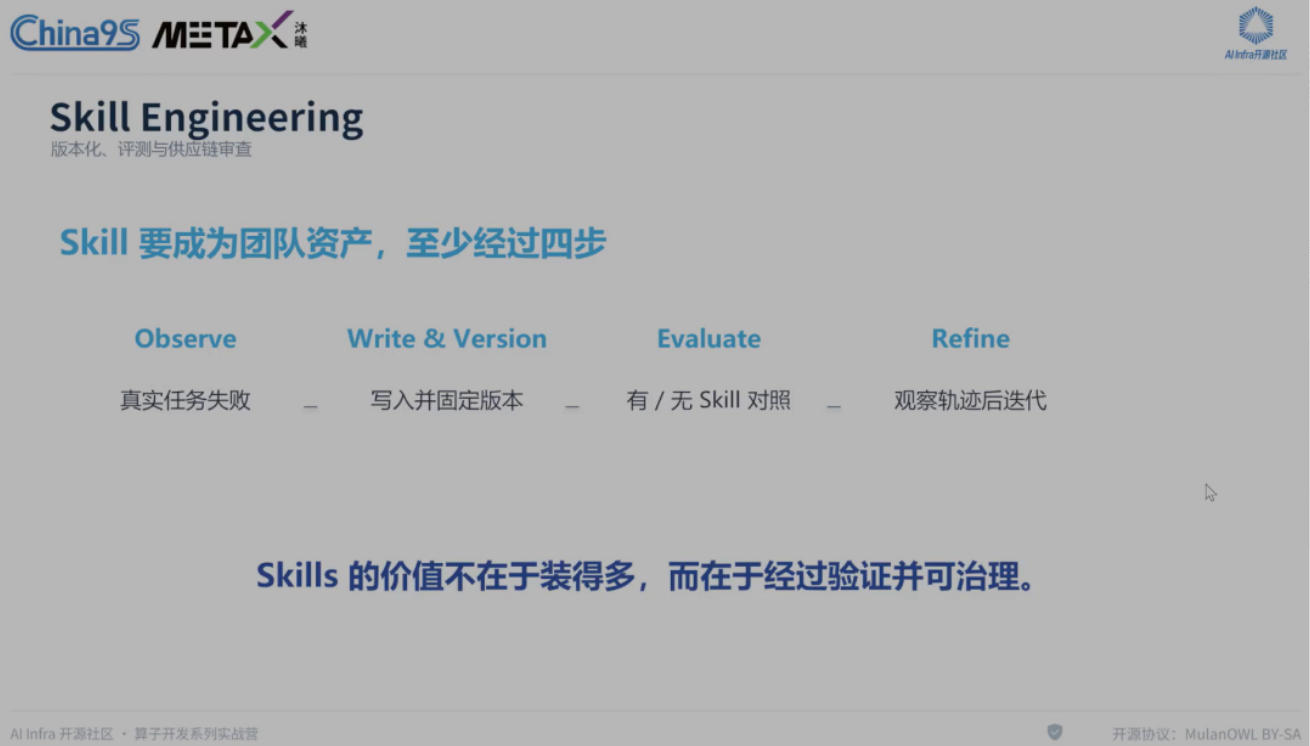
4. Engineering:像代码依赖一样审查第三方 Skill(来源、脚本行为、权限风险)。
四、评测与交付验证
Agent 评测三层次
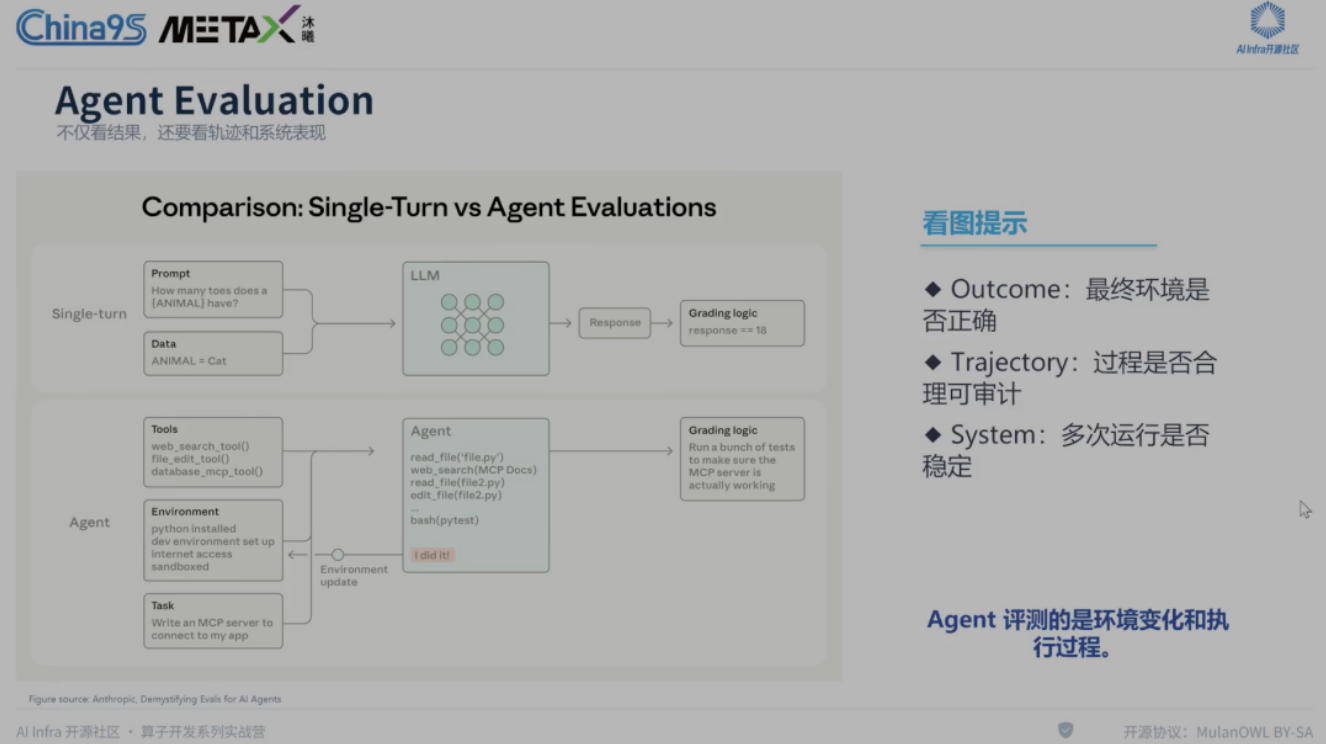
1. Outcome:最终环境是否正确(P99 降低?吞吐提升?)。
2. Trajectory:过程是否合理(是否建立 Baseline?读取正确模块?)。
3. System:多次运行是否稳定(耗时、人工介入度、可复现性)。
Sandbox vs Approval
- Sandbox:技术访问边界(文件、网络、GPU)。
- Approval:人工授权点(高风险动作确认)。
- 人的职责:定义目标、设定边界、承担风险、最终交付判断。
核心总结
- 代码生成 ≠ 软件工程
- 模型 ≠ Agent
- 长上下文 ≠ Relevant Context
- Skill ≠ Prompt 模板
- Task Pass ≠ Delivered Software
五、实战案例——MoE Expert FFN Kernel 优化
阶段 1. 重构数据通路
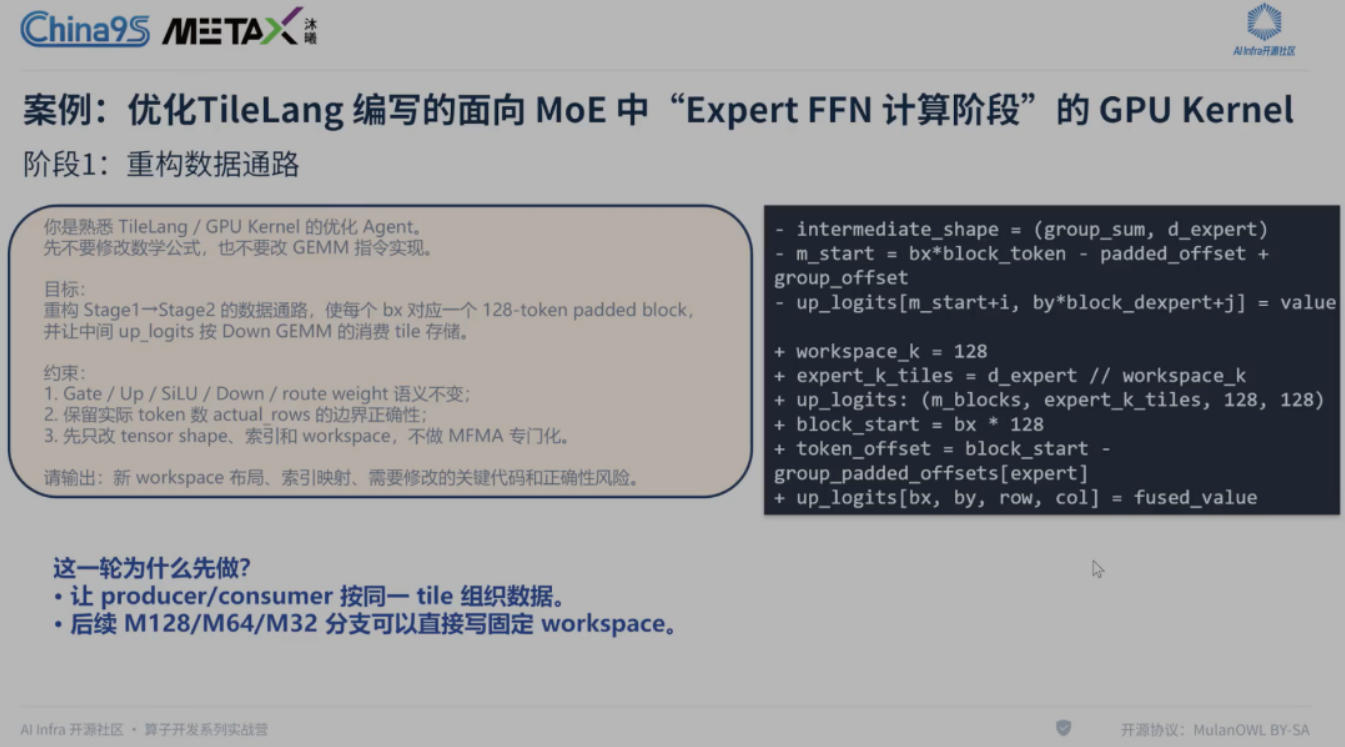
- 不修改数学公式/GEMM,仅调整数据组织方式。
- 生产者-消费者按同一 Tile 对齐,为后续固定 Workspace 打基础。
阶段 2. 优化主路径
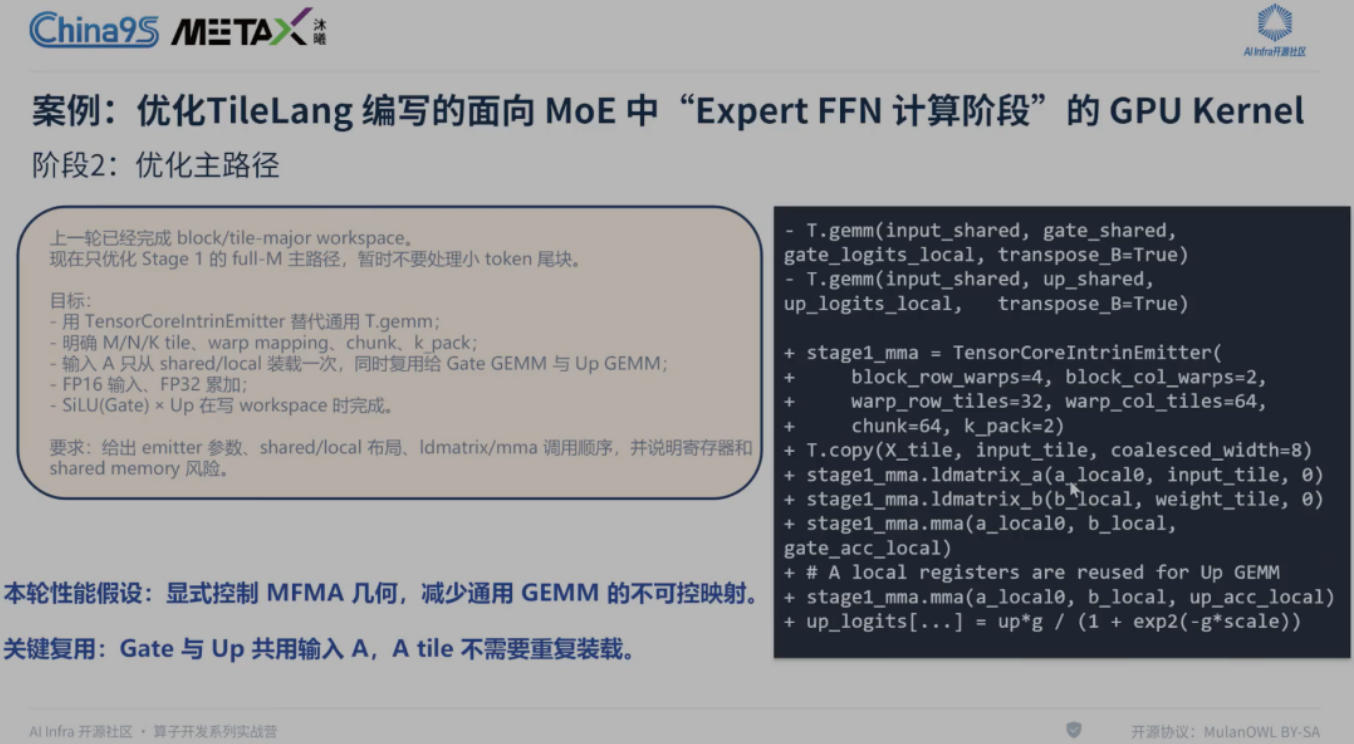
- 拆分通用 GEMM,显式创建 TensorCoreIntrin。
- Gate/Up 复用输入 Token 数据,减少搬运。
阶段 3. 处理 Stage 1 尾块
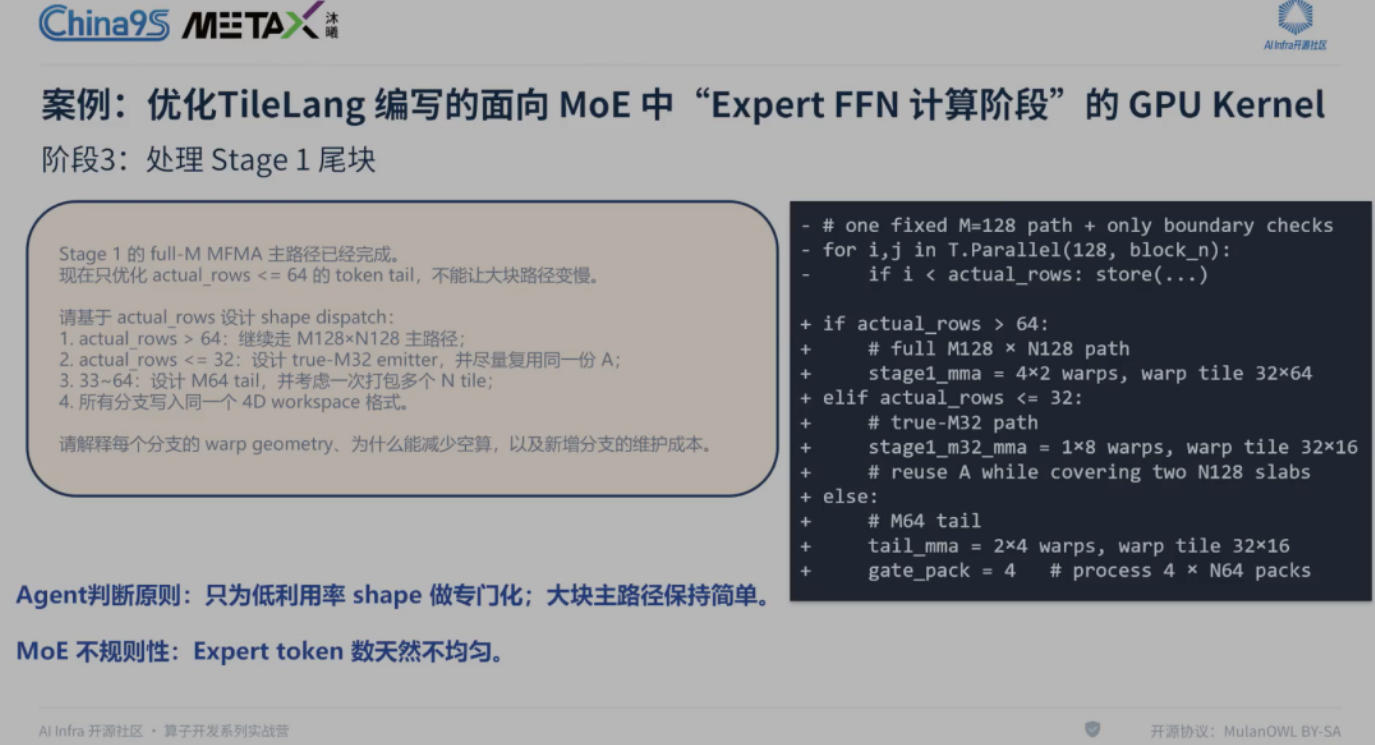
- 针对 MoE 专家 Token 数不均问题。
- 按 actual_rows 分流:>64 走 M128,≤32 走 M32,中间走 M64。
- 避免小块强行使用大 Tile 导致的空算。
阶段 4. 优化 Down GEMM
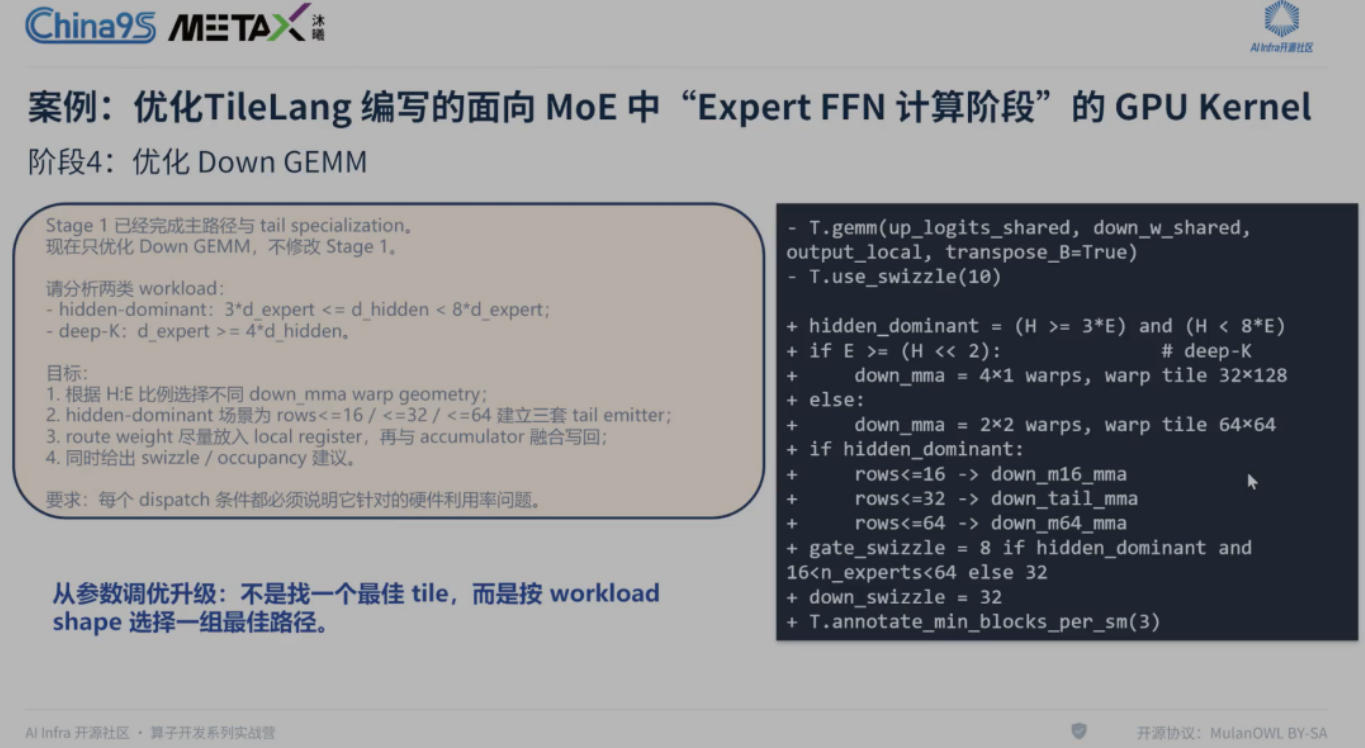
- 判断 hidden-dominant vs deep-K 场景。
- 不同形状匹配不同 Warp 集合,而非万能 Kernel。
阶段 5. 运行时工程开销优化
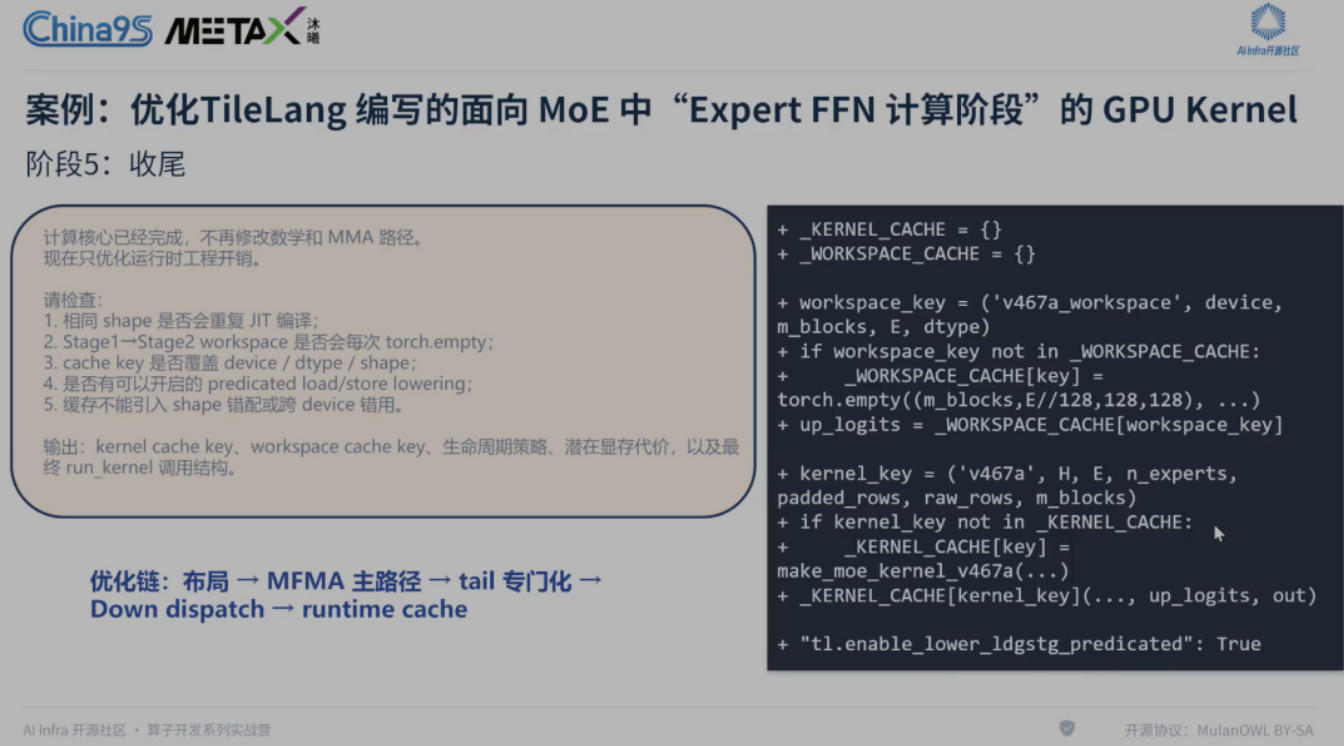
- Kernel Cache:相同 Shape/Config 复用 JIT 编译结果。
- Workspace Cache:相同规格中间 Buffer 复用,避免重复分配。
⚠️ Cache Key 必须完整,防止错误复用。
阶段 6. 优化成果
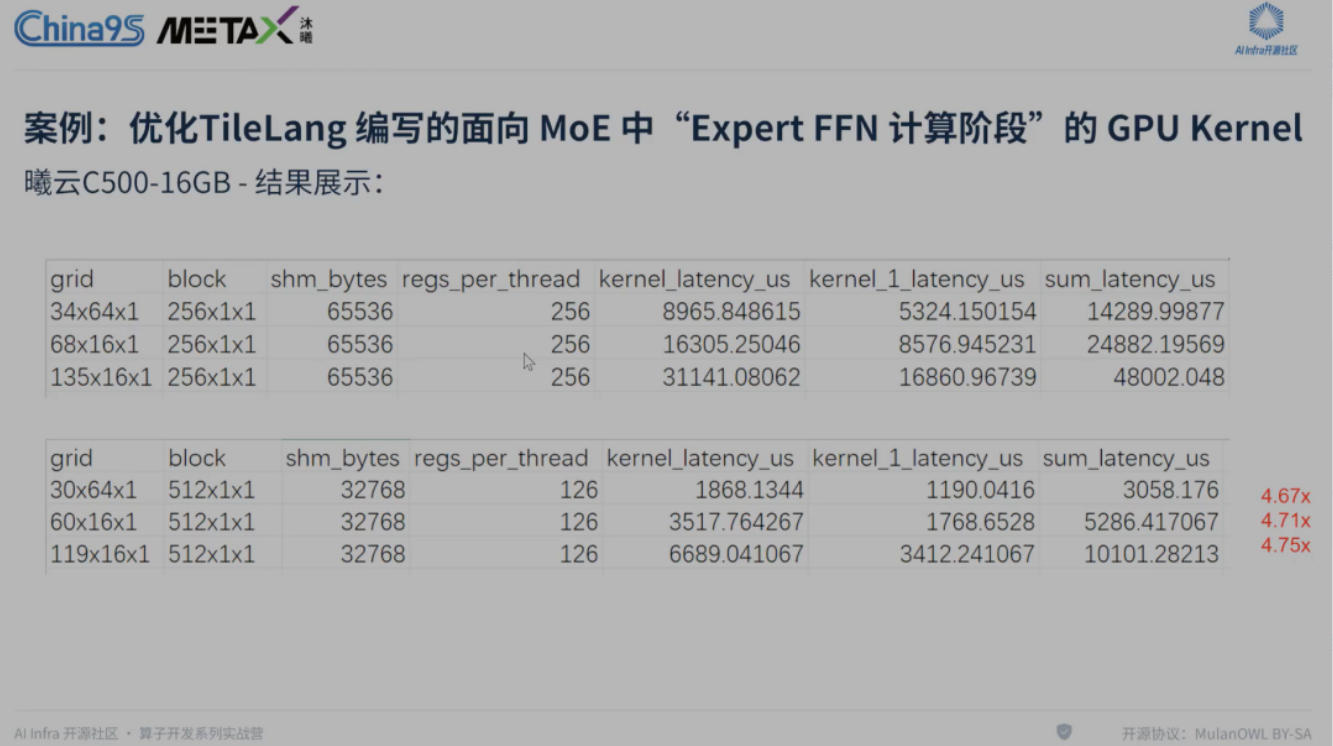
至此“多范式算子开发实战营”课程内容已完结,接下来进入学员项目完成阶段,检验学习成果。
还想进一步参与?
InfiniTensor 训练营等你加入!
如果你对 AI 相关知识感兴趣,欢迎关注并加入九源智能计算系统生态联合体、启元实验室主办的 InfiniTensor 大模型与人工智能系统训练营——一个完全免费的人工智能一站式教育训练营,每年夏季、冬季开营,从算力硬件到大模型全流程课程学习,零基础也能跟上!
训练营亮点:
• 完全免费:全程免费学习,从入门到进阶一路护航;
• 门槛宽松:不限背景、不限学历、不限经验,对人工智能与大模型技术有兴趣即可报名;
• 课程硬核:覆盖系统编程语言、大模型推理、算子开发、AI 编译器、性能优化等课程,还有大咖课与项目实战;
• 学练结合:配套习题、算力资源与实战项目,优秀学员可获得结业证书。
关注与参与方式:
• 关注 InfiniTensor 公众号,第一时间获取训练营报名、课表与课程动态
• 前往 InfiniTensor 开源社区官网(https://www.infinitensor.com/) 注册账号、完善个人信息即可完成报名,全程免费!
关注与交流