9 月 17 日晚,多范式算子开发实战营继续邀请九齿 DSL 技术负责人黄嘉成老师,带来《基于九齿复杂算子实现案例》。
在之前的课程中,我们了解了多种 DSL 并初步体验了九齿的基础写法。但如何从简单的“向量加法”进阶到真正的复杂算子,本节课将深入实战,带大家掌握矩阵乘法(GEMM) 与 Flash Attention 的九齿实现,并学会使用 Roofline Model 科学评估算子性能。
一、 矩阵乘法(GEMM)的并行算法与九齿实现
算法原理回顾
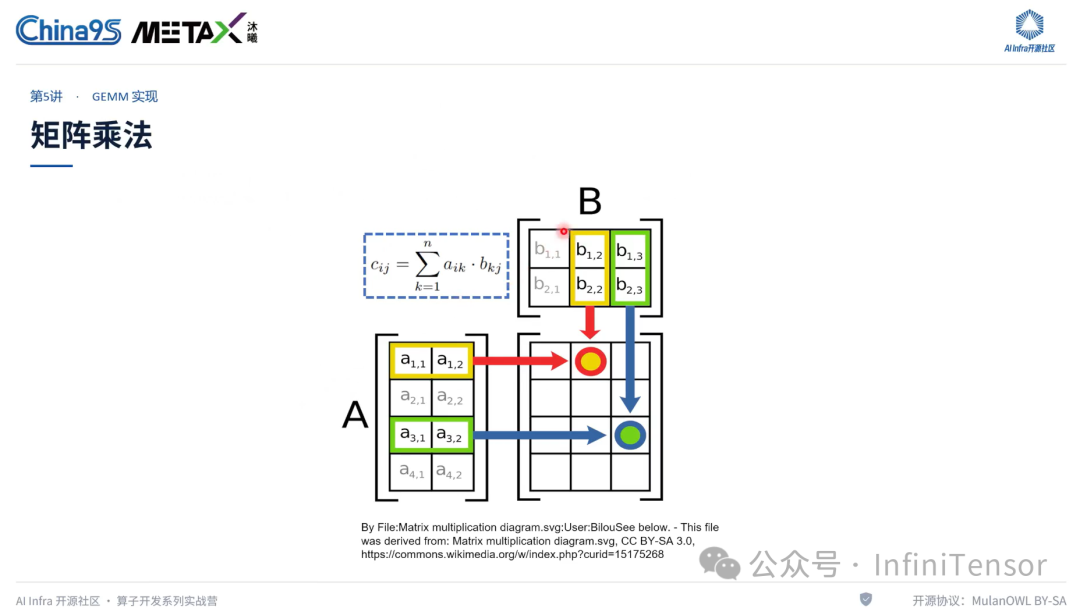
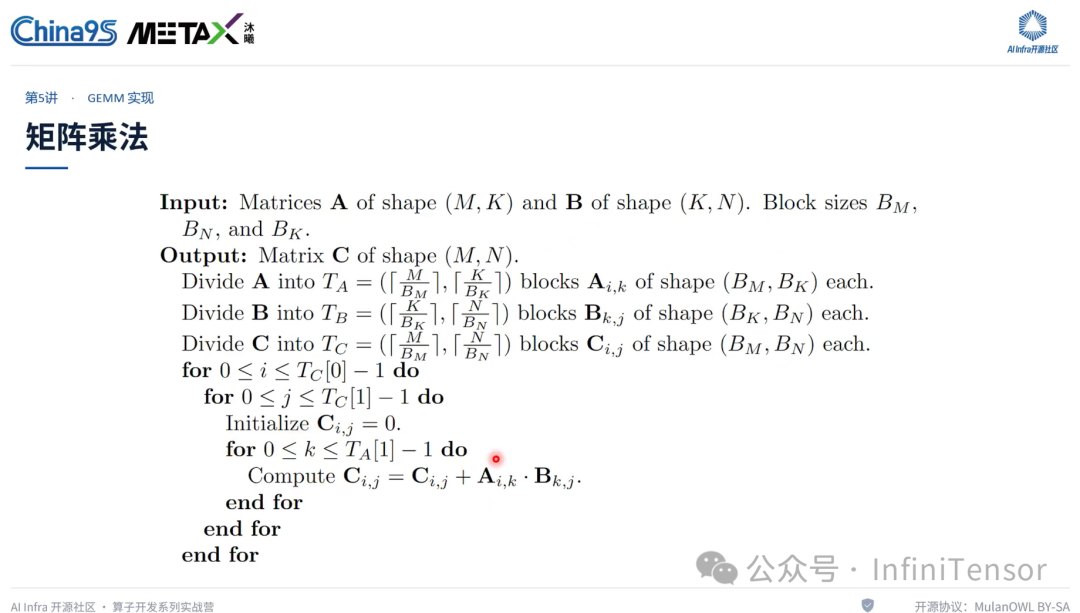
1. 数学定义:$C = A imes B$,其中 $C$ 的每个元素对应 $A$ 的一行与 $B$ 的一列的乘累加。
2. 朴素实现的瓶颈:三重循环(CPU串行思维)未考虑缓存与并行,性能极低。
3. GPU 分块并行策略(Tiling):
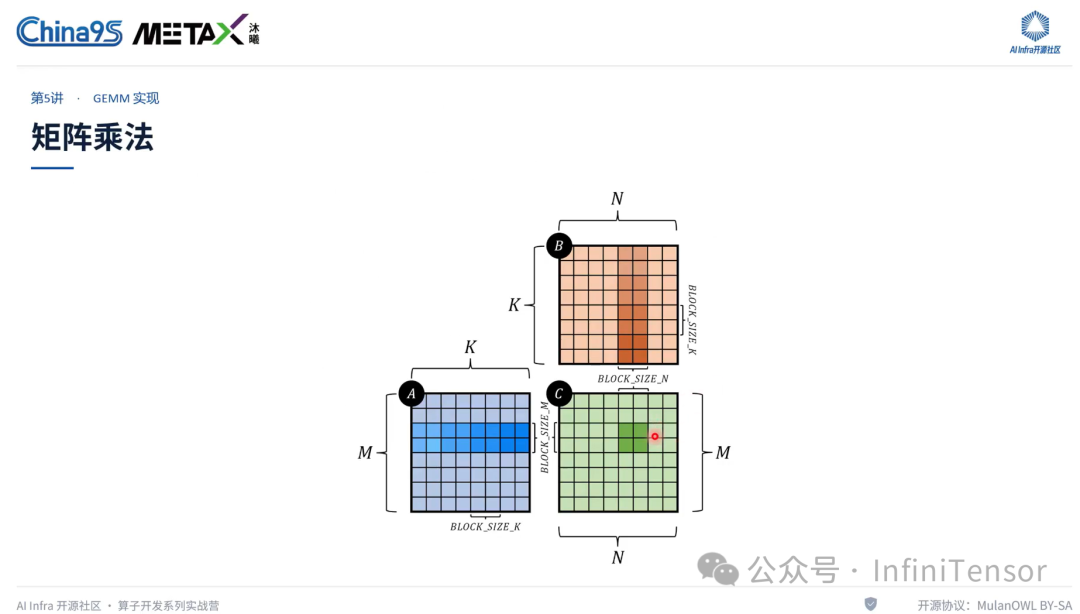
- 将 $C$ 切分为 $BM imes BN$ 的块。
- 对应 $A$ 的行块 ($BM imes BK$) 与 $B$ 的列块 ($BK imes BN$)。
- 核心逻辑:$C$ 的一个输出块对应 $A$ 的一整行块和 $B$ 的一整列块,通过沿 $K$ 维度遍历累加小矩阵乘结果。
- 边界处理:使用
cdiv(Ceiling Division) 向上取整,确保非整除情况下的数据完整性。
九齿实现 GEMM
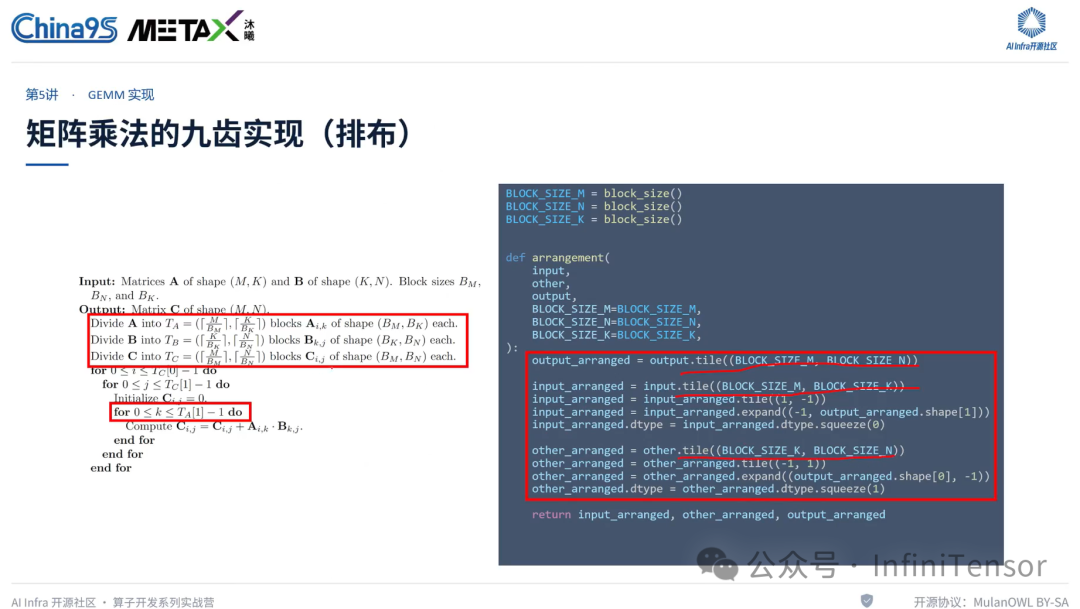
1. 排布(Arrangement)分离计算:
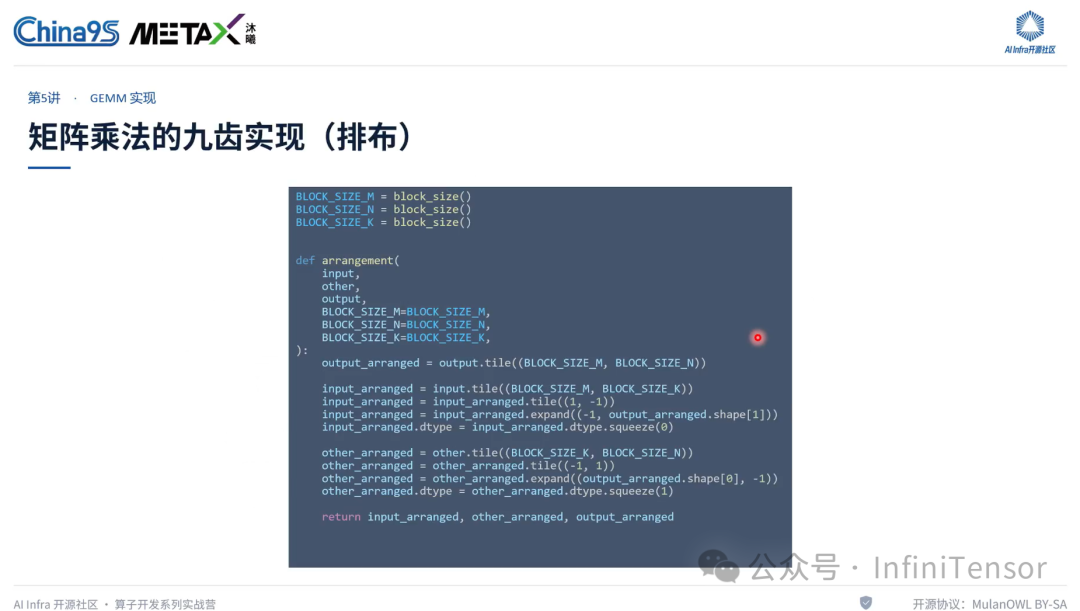
- Tile:对 $A, B, C$ 进行基础分块;对 $A$ 按行、$B$ 按列进行二次 Tile,以匹配 $C$ 的计算需求。
- Expand:将 $A$ 的行块和 $B$ 的列块复制扩展,建立与 $C$ 所有输出块的映射关系(逻辑复制,无实际内存开销)。
- Squeeze:移除冗余的单例维度(长度为 1 的维度),简化 Application 中的索引编写。
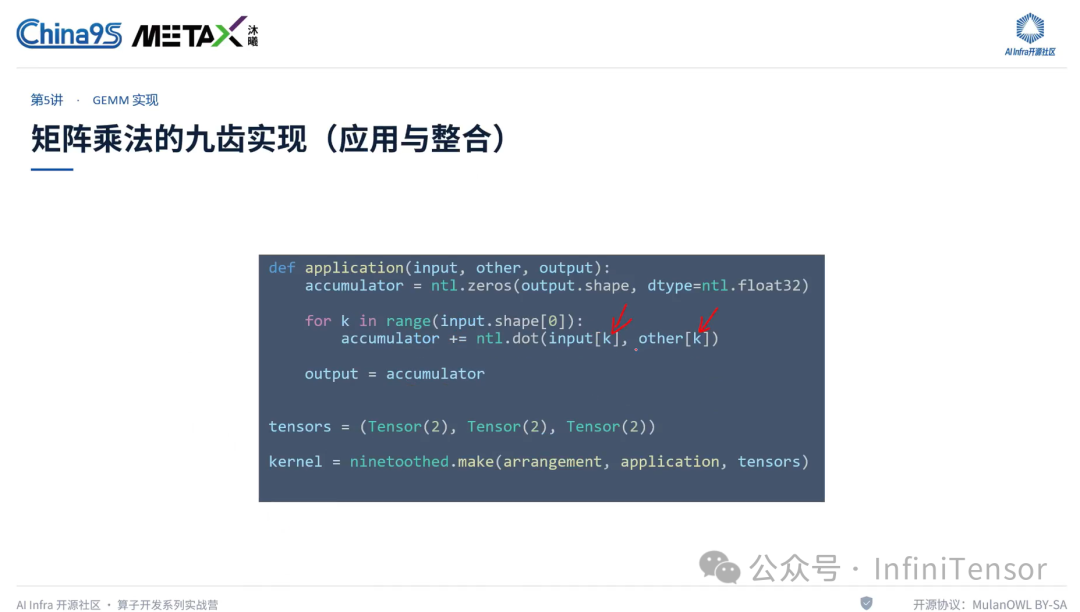
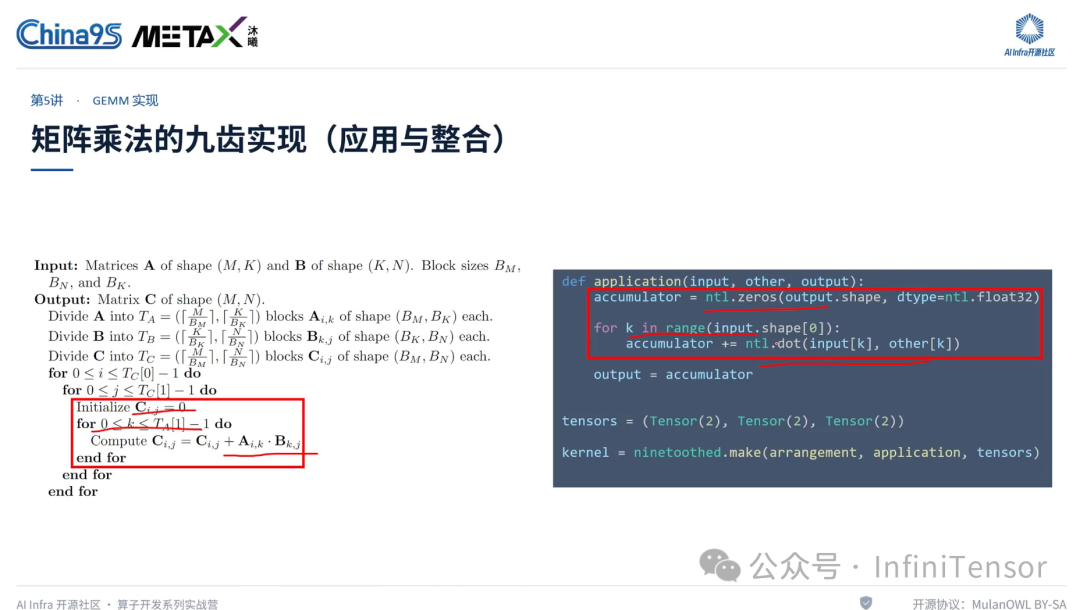
2. 计算(Application):
- 输入输出均为“排布后的块”而非原始张量。
- 在 Application 内遍历 $K$ 维度的小块,执行小矩阵乘与累加。
3. 自动推导机制:
- 九齿无需手动配置 Grid/Block,编译器根据最外层张量形状的一致性自动推导 Launch 配置。
- 原则:$A, B, C$ 排布后的最外层形状必须一致。
可视化辅助理解
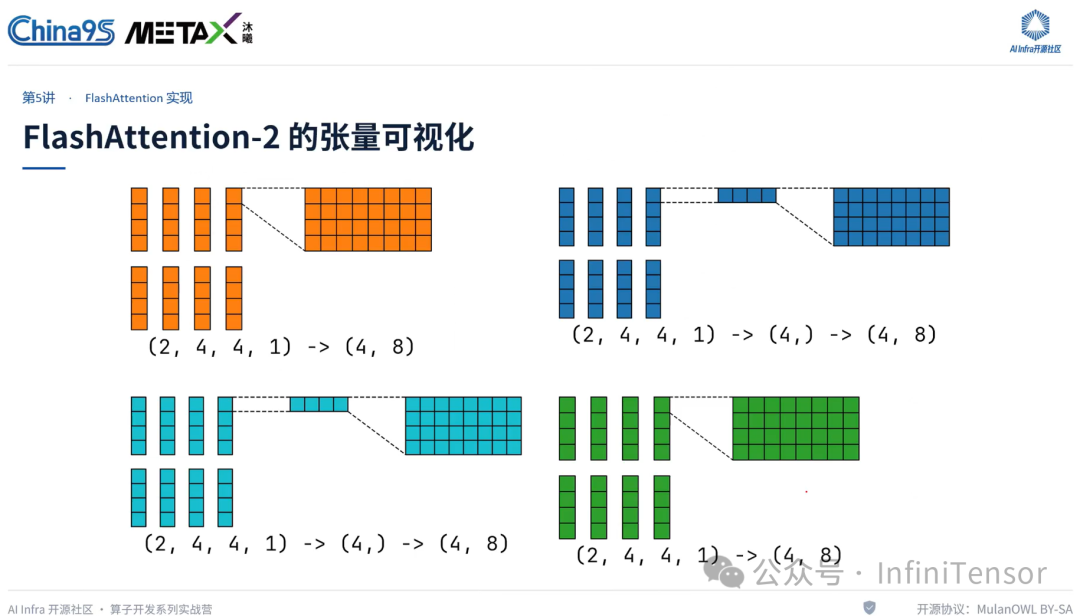
1. 嵌套张量可视化:直观展示 Tile 产生的层级结构(单层→双层→三层)。
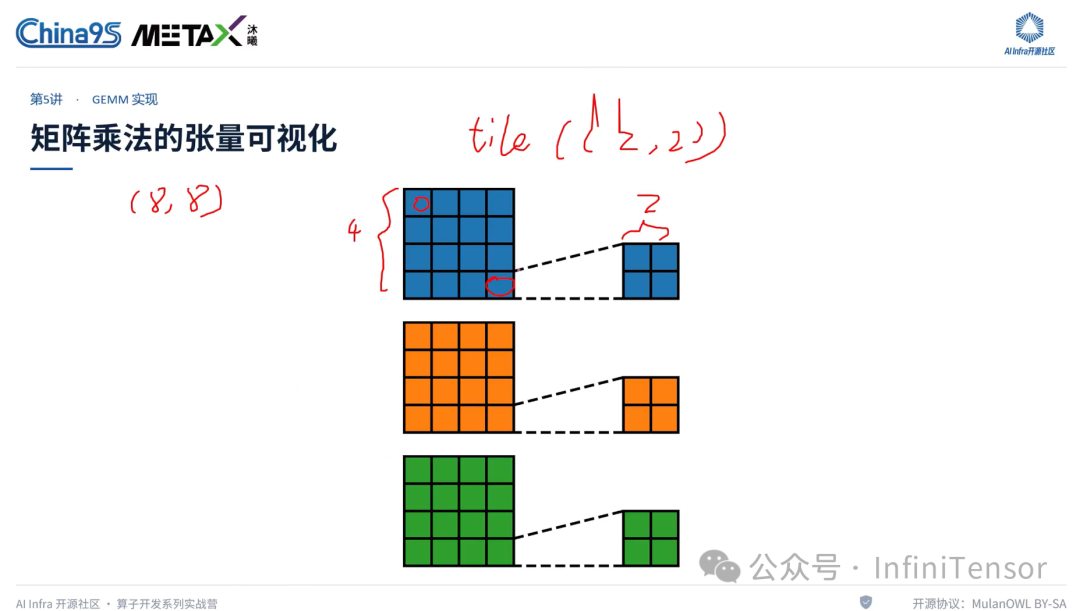
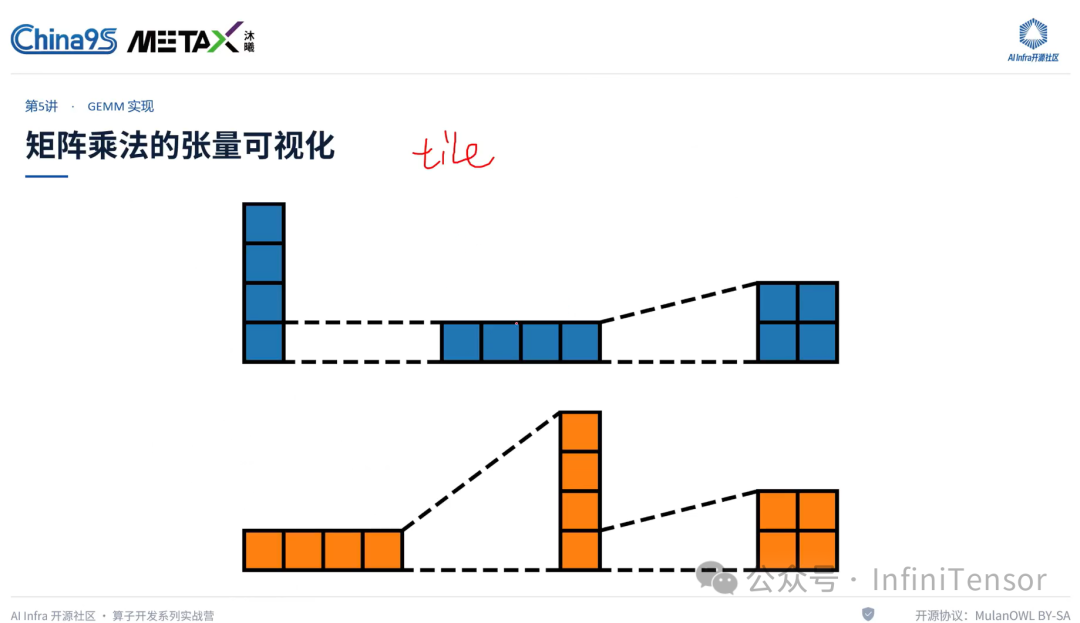
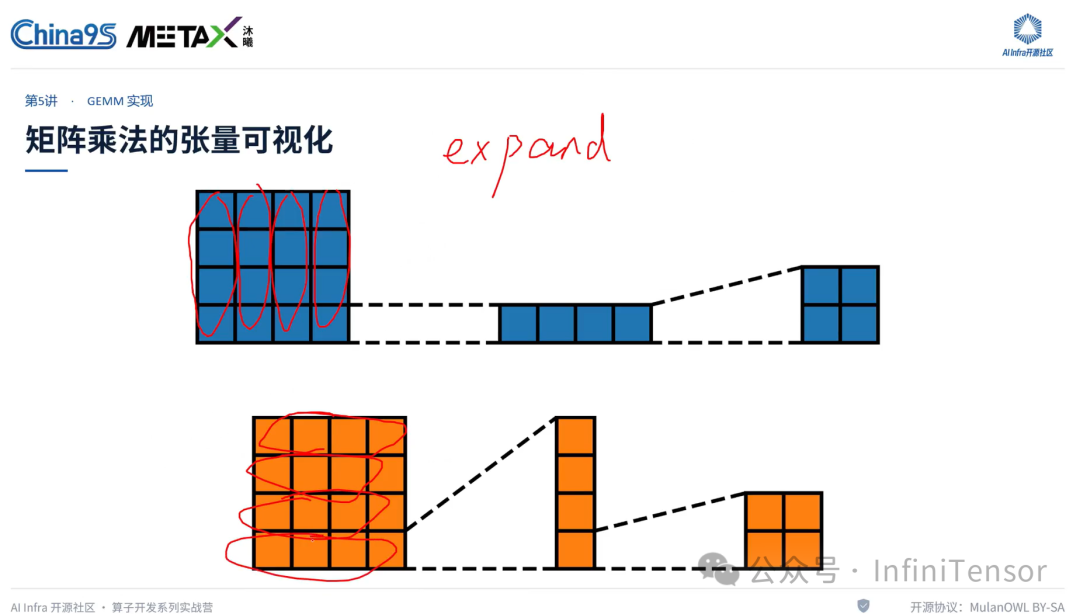
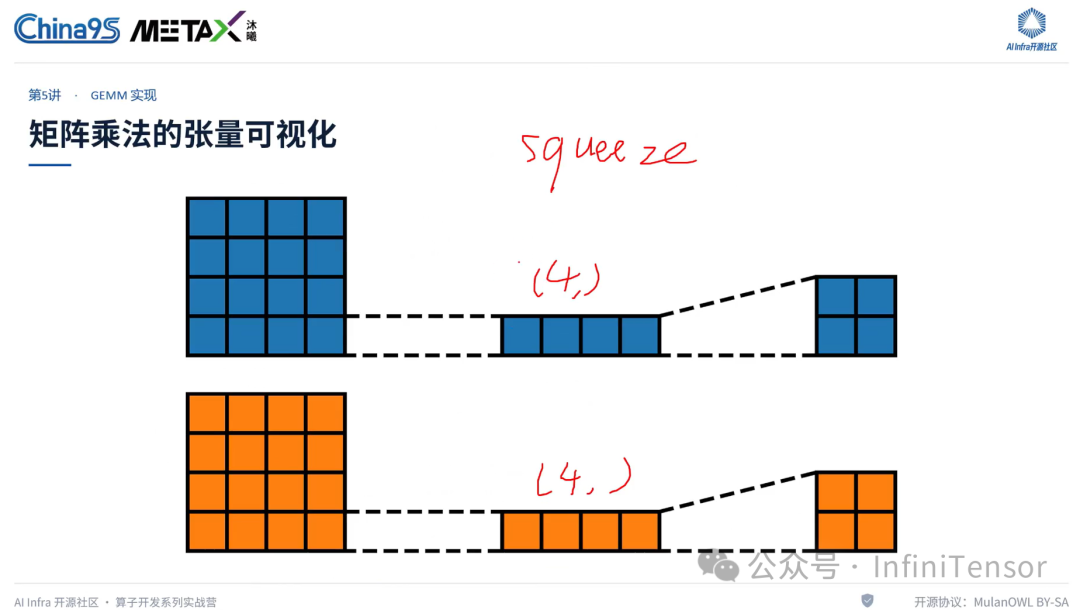
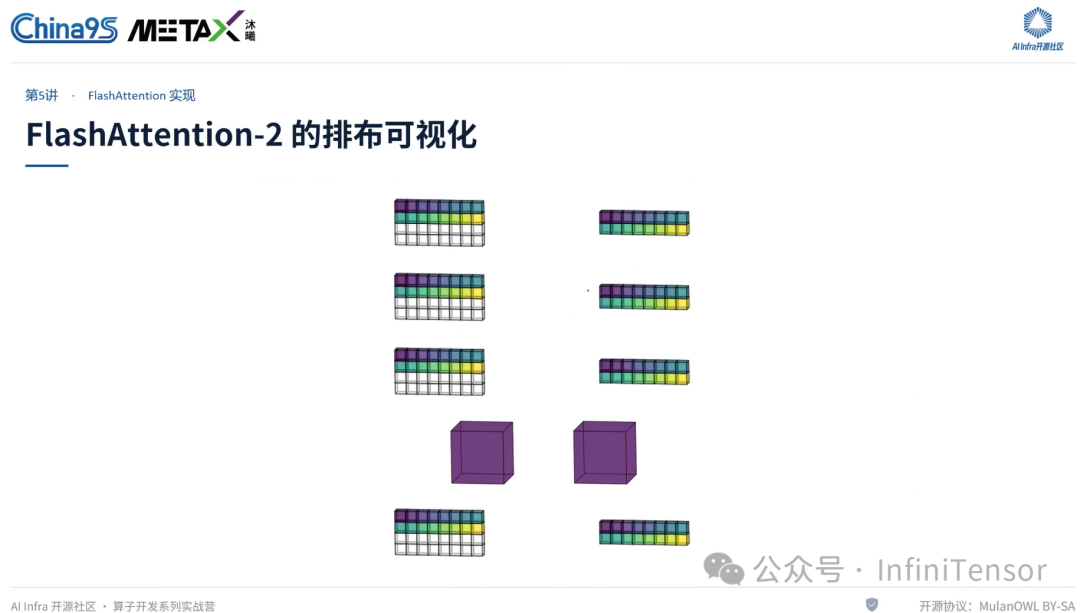
2. 排布可视化:验证排布后的块与原始张量位置的对应关系,辅助 Debug。
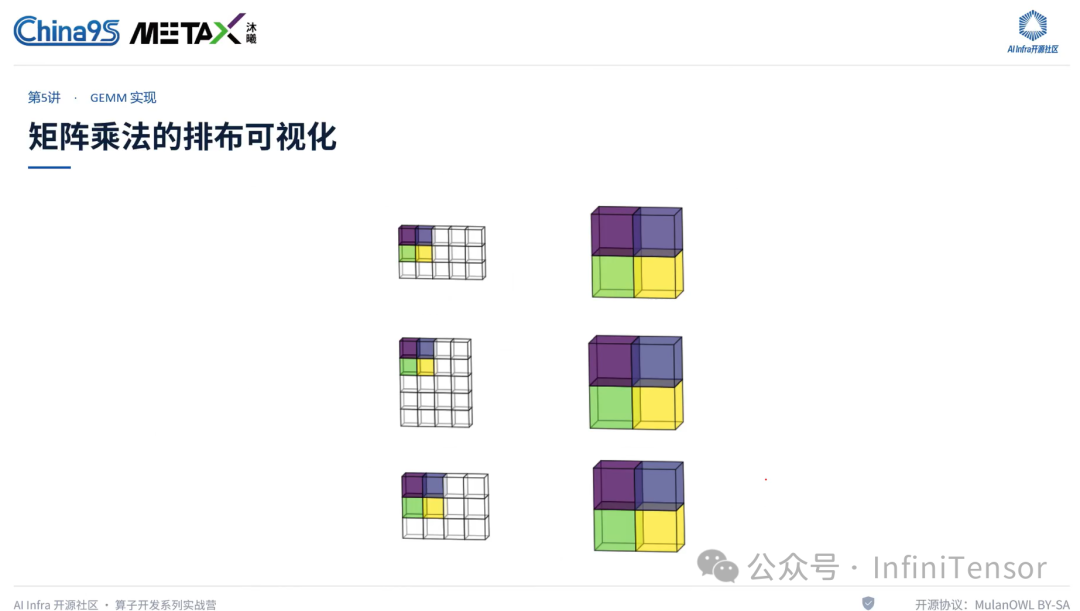
3. 代码与算法描述一致:九齿代码结构与数学/算法描述高度一致,降低认知负担。
二、 Kernel 性能评估:Roofline Model
Roofline Model 核心概念
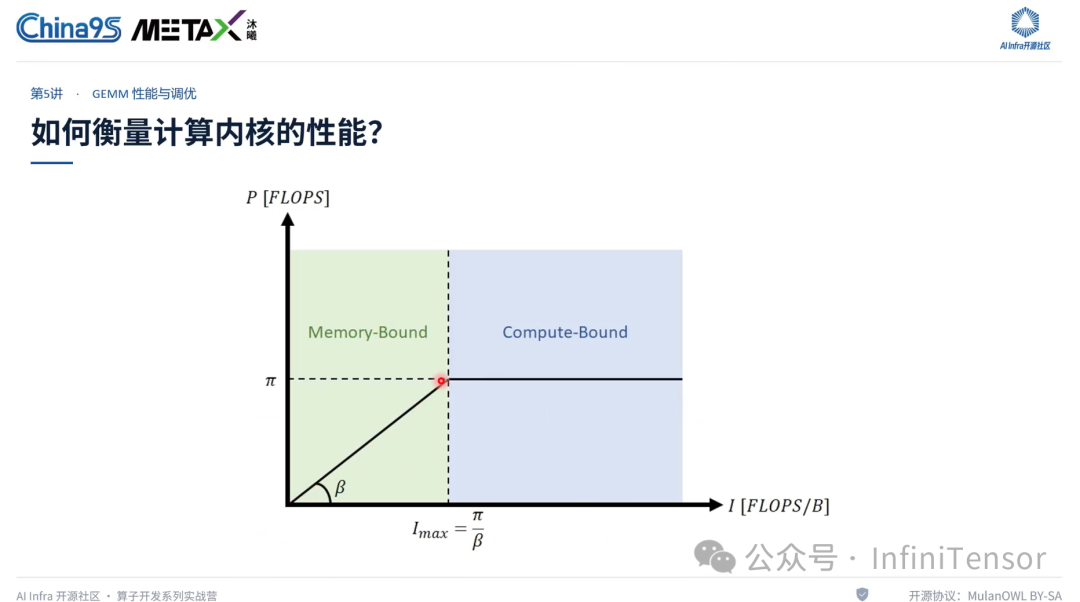
1. 横轴:Arithmetic Intensity,即计算密度(FLOPs / Byte)。
2. 纵轴:Performance (FLOPS)。
3. 两大区域:
- Memory Bound:受限于显存带宽
- Compute Bound:受限于峰值算力
4. 拐点意义:区分优化方向的关键,不同 Case 可能落在不同区域。
5. 性能指标:Compute Bound 看 FLOPS,Memory Bound 看 GB/s,通用标准看耗时。
Benchmark 实战方法
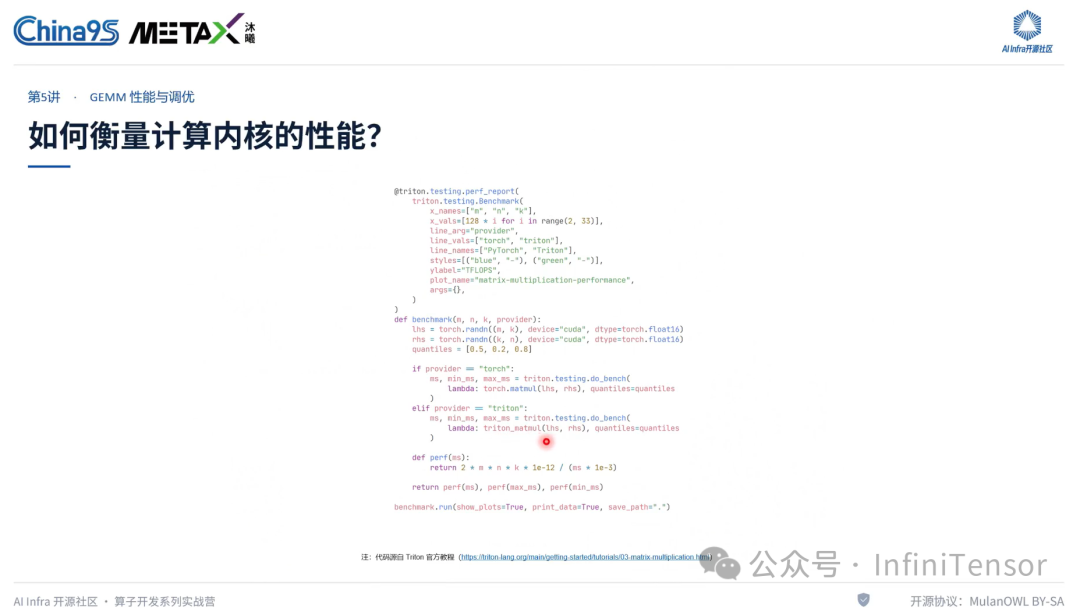
1. perf 函数:$2 imes M imes N imes K$ (乘+加各一次)。
2. 数据搬运量:$M imes K + K imes N + M imes N$。
三、 FlashAttention
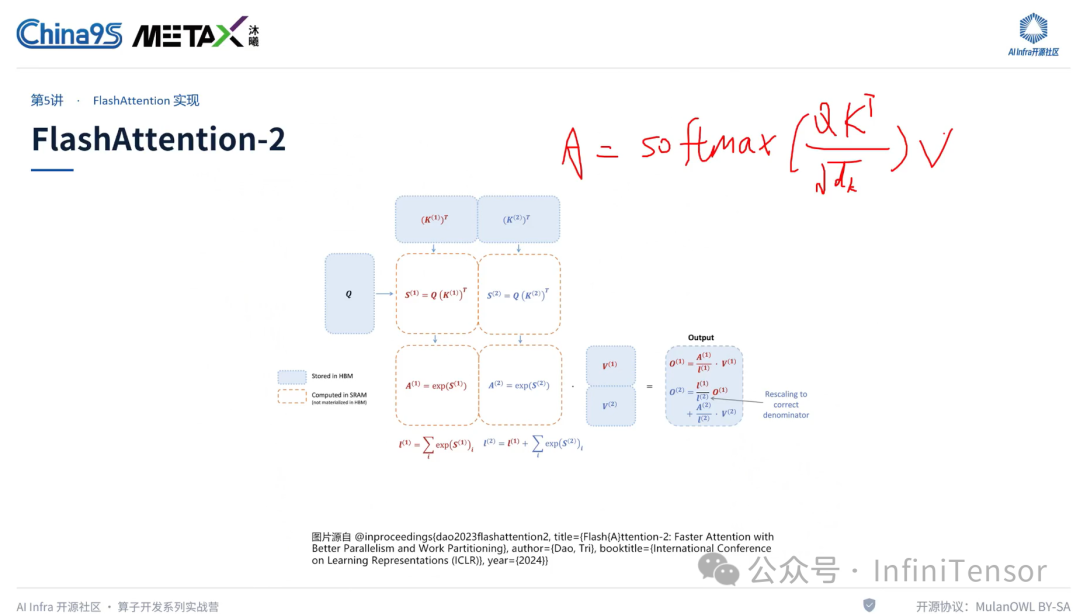
为什么需要 FlashAttention?
1. 传统 Attention 痛点:$QK^T$ 结果巨大,多次读写 Global Memory 导致性能低下。
2. 核心思想:基于 Online Softmax 原理,将 MatMul + Softmax + MatMul 融合为一个 Kernel,减少全局内存访问。
3. 算法特征:$Q/O$ 按 $BM$ 分块,$K/V$ 按 $BN$ 分块;每个 $Q$ 块对应多个 $K/V$ 块。
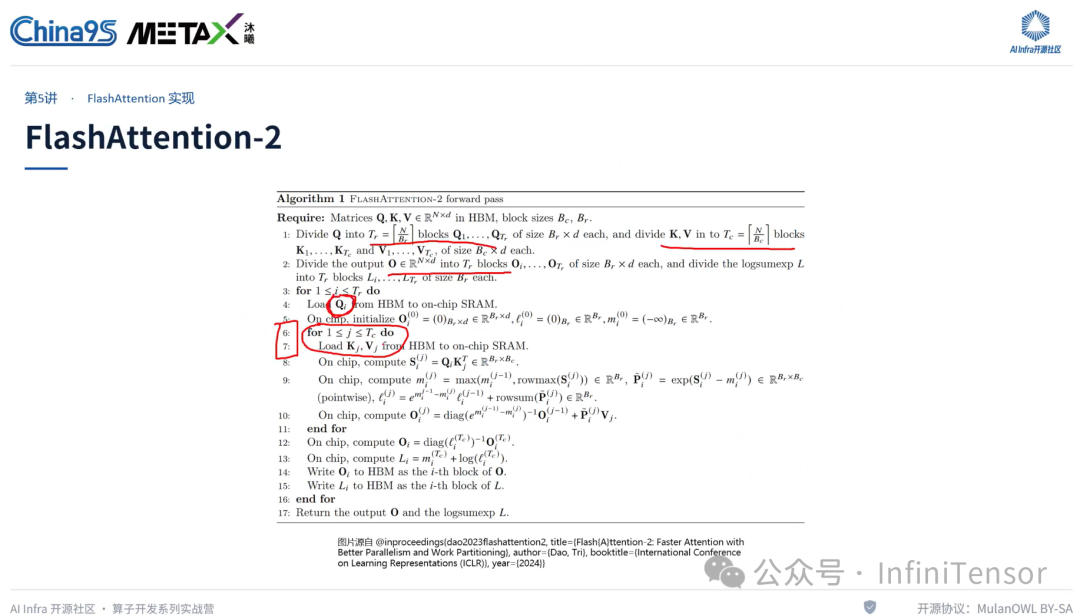
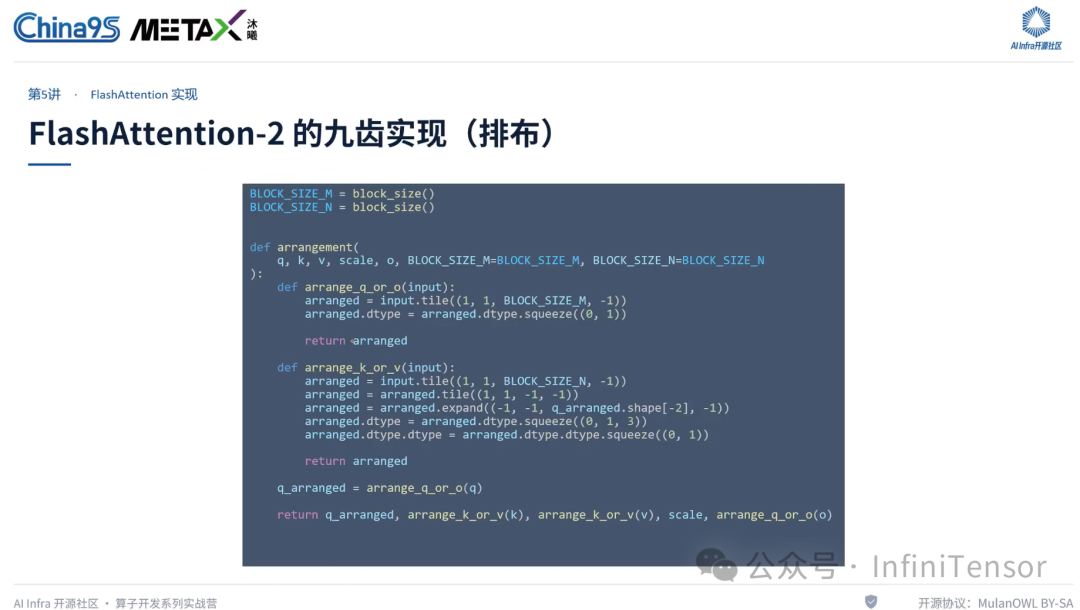
九齿实现要点
1. Arrangement 设计:
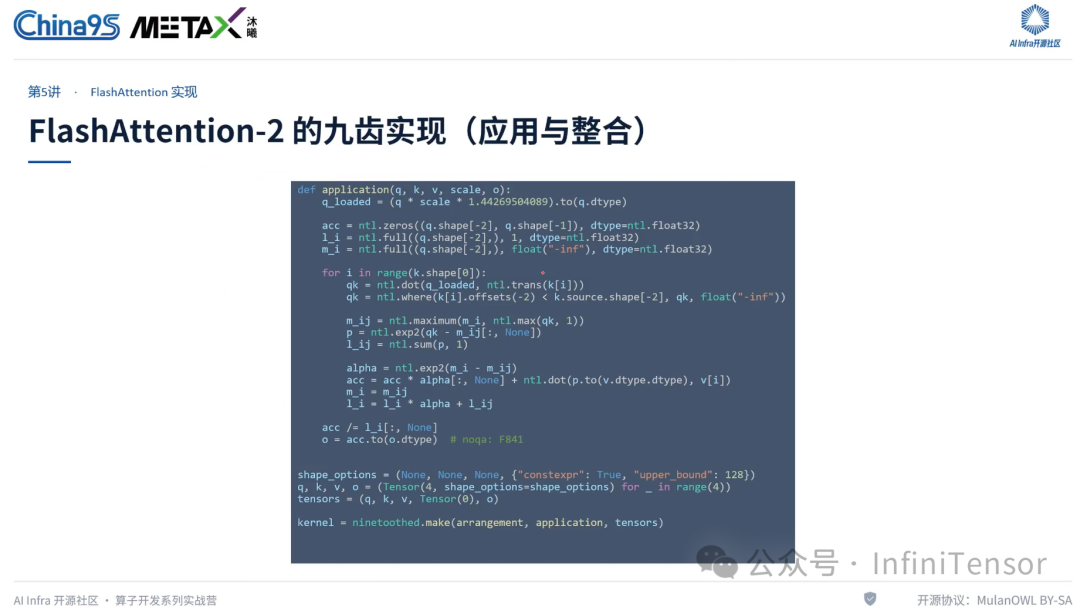
2. Application 编写:
3. 张量可视化
4. 排布可视化
关注与交流