9 月 13 日晚,由九源开源社区联合沐曦 GPU 与 MXMACA 软件栈、 AI Infra 开源社区、GitLink 开源平台、DataWhale 开源学习社区及启悟学习社区联合推出的 「多范式算子开发实战营」 正式开营。
为什么叫"多范式"?
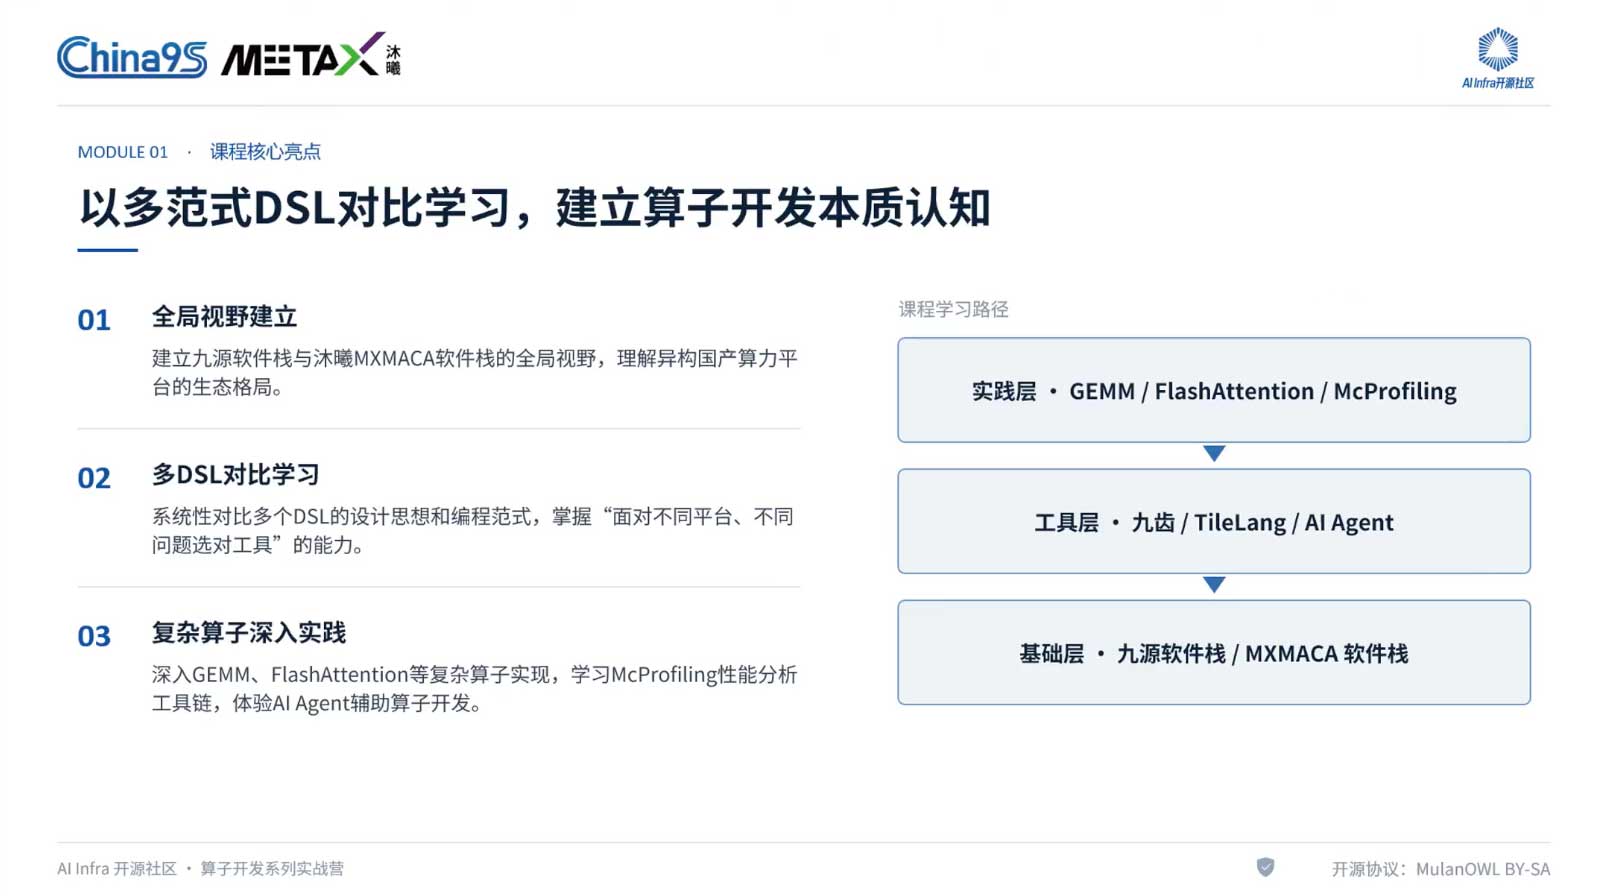
本次实战营主打多个 DSL 的对比学习,帮助学员建立对算子开发的本质认知。课程内容包括:
- 全局视野建立:了解九源软件栈和沐曦 MXMACA 软件栈,理解异构国产算力平台的生态格局
- 多 DSL 对比:系统性比较多个 DSL 的设计思想和编程范式,掌握在不同场景、平台和问题下选择合适工具的能力
- 复杂算子实战:深入学习 Flash Attention、GEMM 等复杂算子的实现核心技术
- 性能分析优化:学习使用 McProfiling 等性能分析工具,掌握算子性能瓶颈的定位与优化方法
- AI Agent 辅助开发:探索人机协作新范式,体验用 AI Agent 提升算子开发效率
课程设计与学习方式
- 每周两次直播课程,由老师带领了解核心技术并展示实操
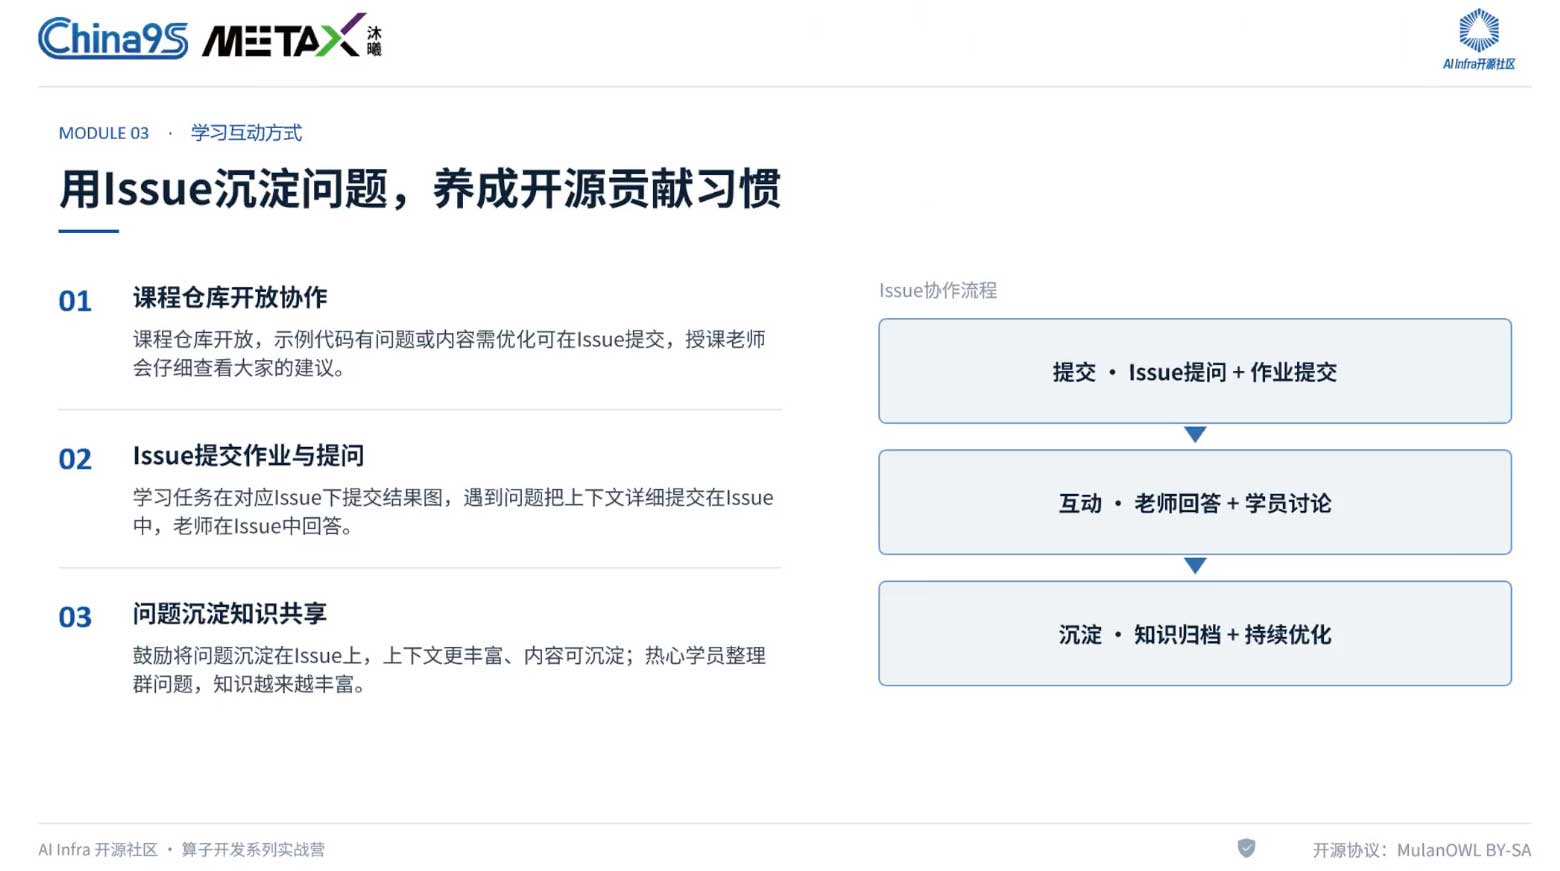
- GitLink 课程仓库 提供完善的脚手架代码和学习任务
- 任务驱动学习:通过动手实践验证知识点
- 课后回放:课程内容上传至 B 站和 DataWhale 课程主页,方便反复学习
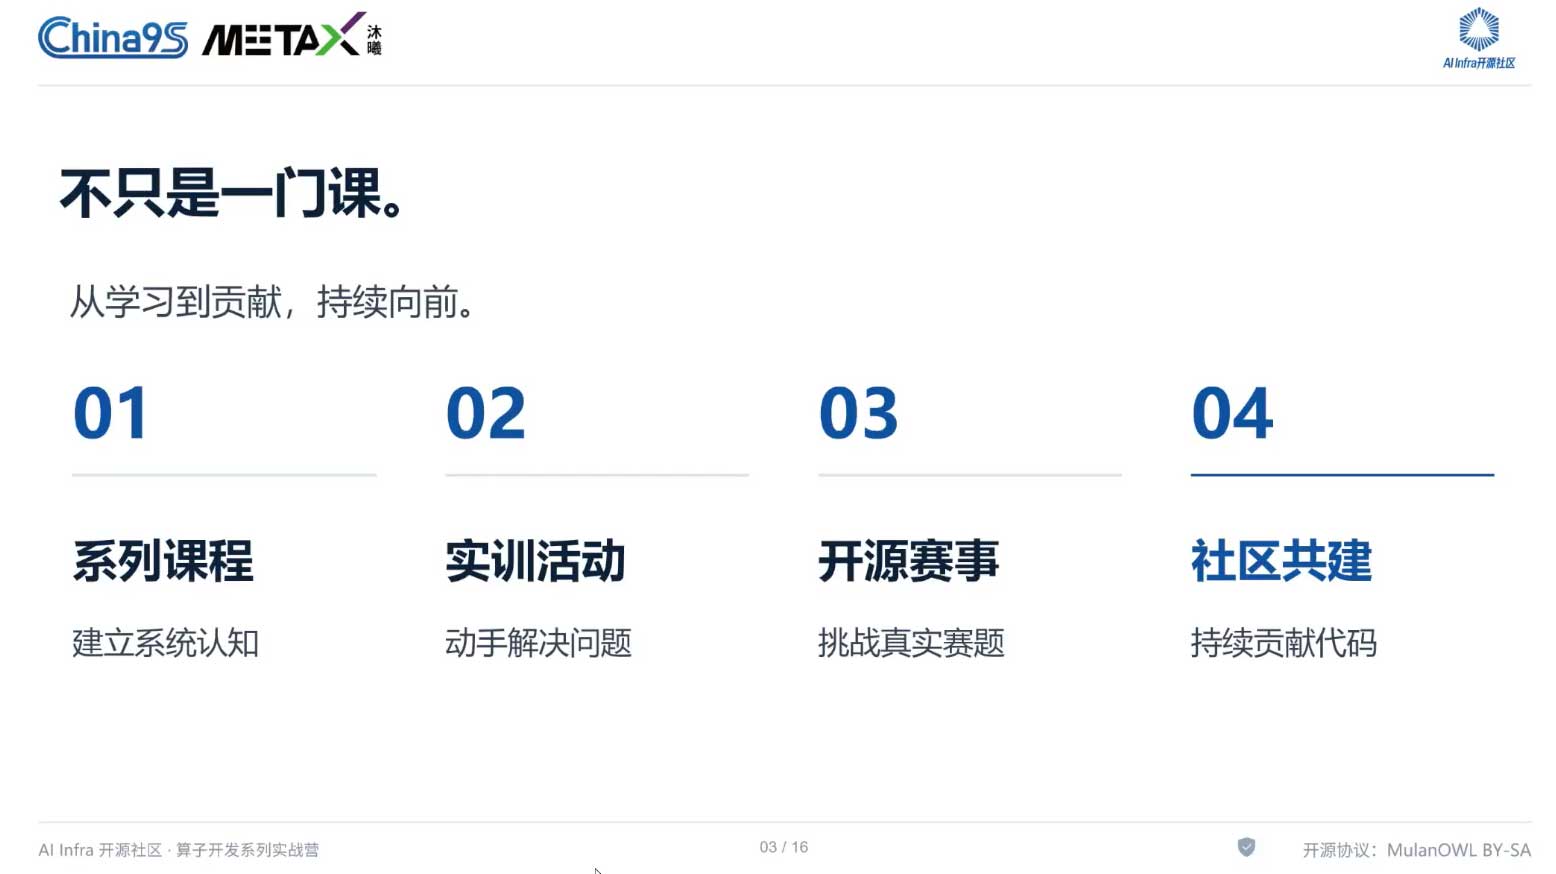
四项学习福利
| 福利 | 内容 |
|---|---|
| 🎫 免费算力券 | 所有动手环节均可通过沐曦开发者社区领取的算力券完成 |
| 💻 示例代码 | GitLink 学习仓库提供完善可靠的可运行示例代码 |
| 📜 结营证书 | 按时完成所有学习任务并通过审核,可获沐曦盖章结营证书 |
| 🎁 激励活动 | 在社交媒体分享学习心得,有机会获得沐曦定制周边大礼包 |
吕墨尘老师开营分享:
《从调用 AI 到构建 AI》
主讲人:九源智能计算系统生态联合体吕墨尘老师
九源在做什么?
九源围绕 统一的软件架构,推进编程语言、算子、通信、训练、推理等基础软件建设。目标不是做几场独立的技术分享,而是打造一条 可持续走下去的学习路径:
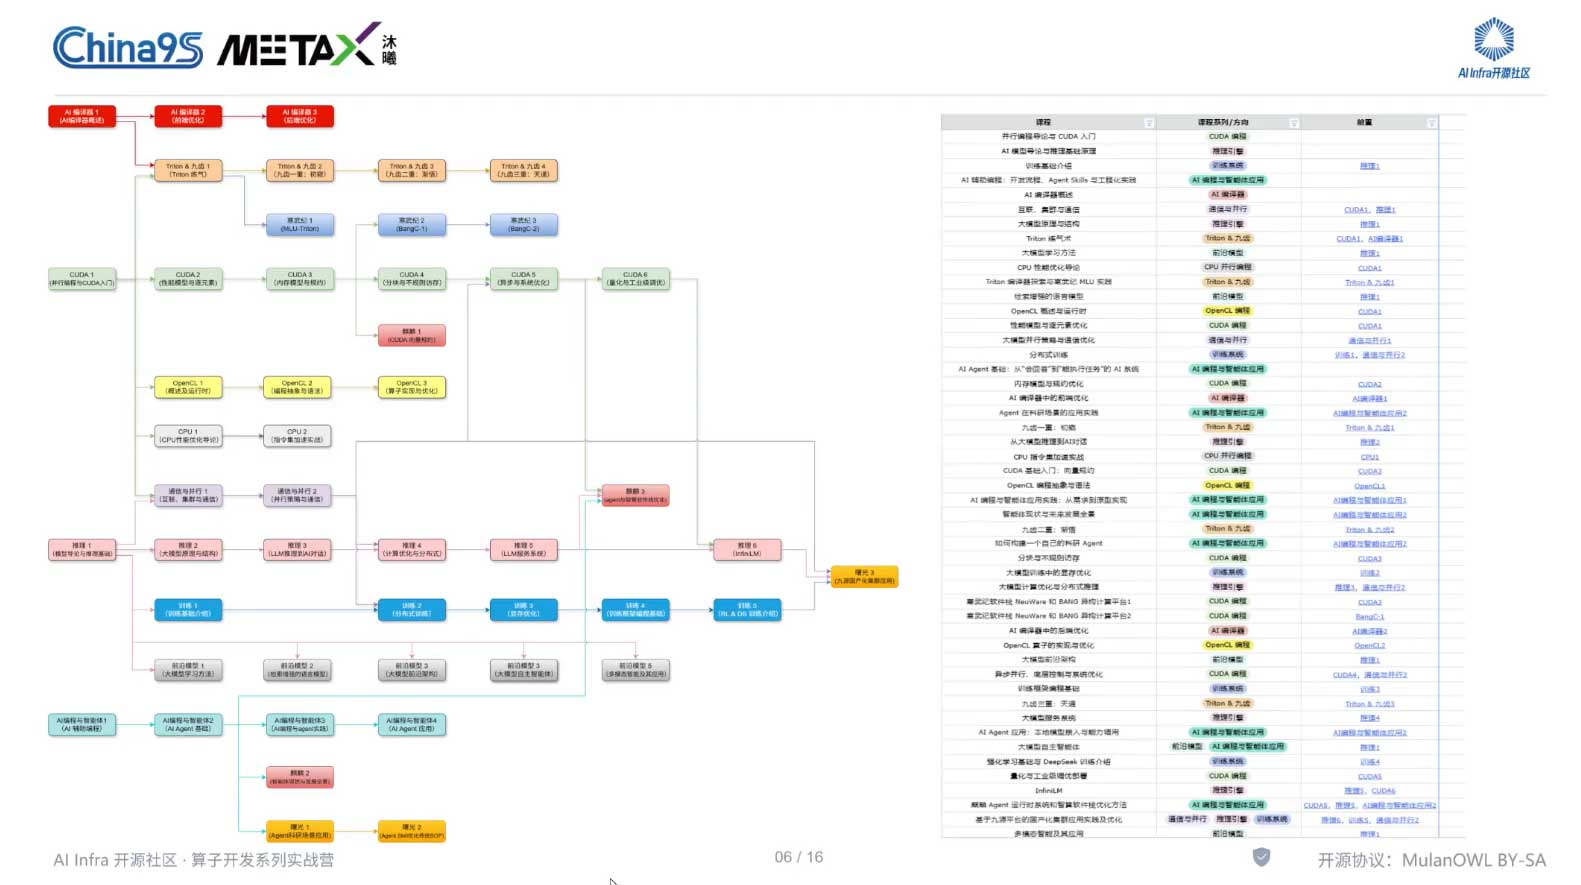
InfiniTensor 大模型与人工智能系统训练营
- 自 2024 年夏季开始,已持续举办 4 期,累计吸引 上万名学员
- 课程三大板块:
- 基础专业课:各方向核心知识和基本方法
- 行业合作课:企业工程师带真实开发场景讲解
- 大咖课:学术界和产业界老师分享研究进展与实践经验
课程体系覆盖
- 并行编程: CUDA、Triton、九齿、OpenCL、CPU 并行编程
- 系统方向: AI 编译器、训练系统、大模型推理服务系统、通信与并行优化
- 新增课程: AI 编程与智能体应用
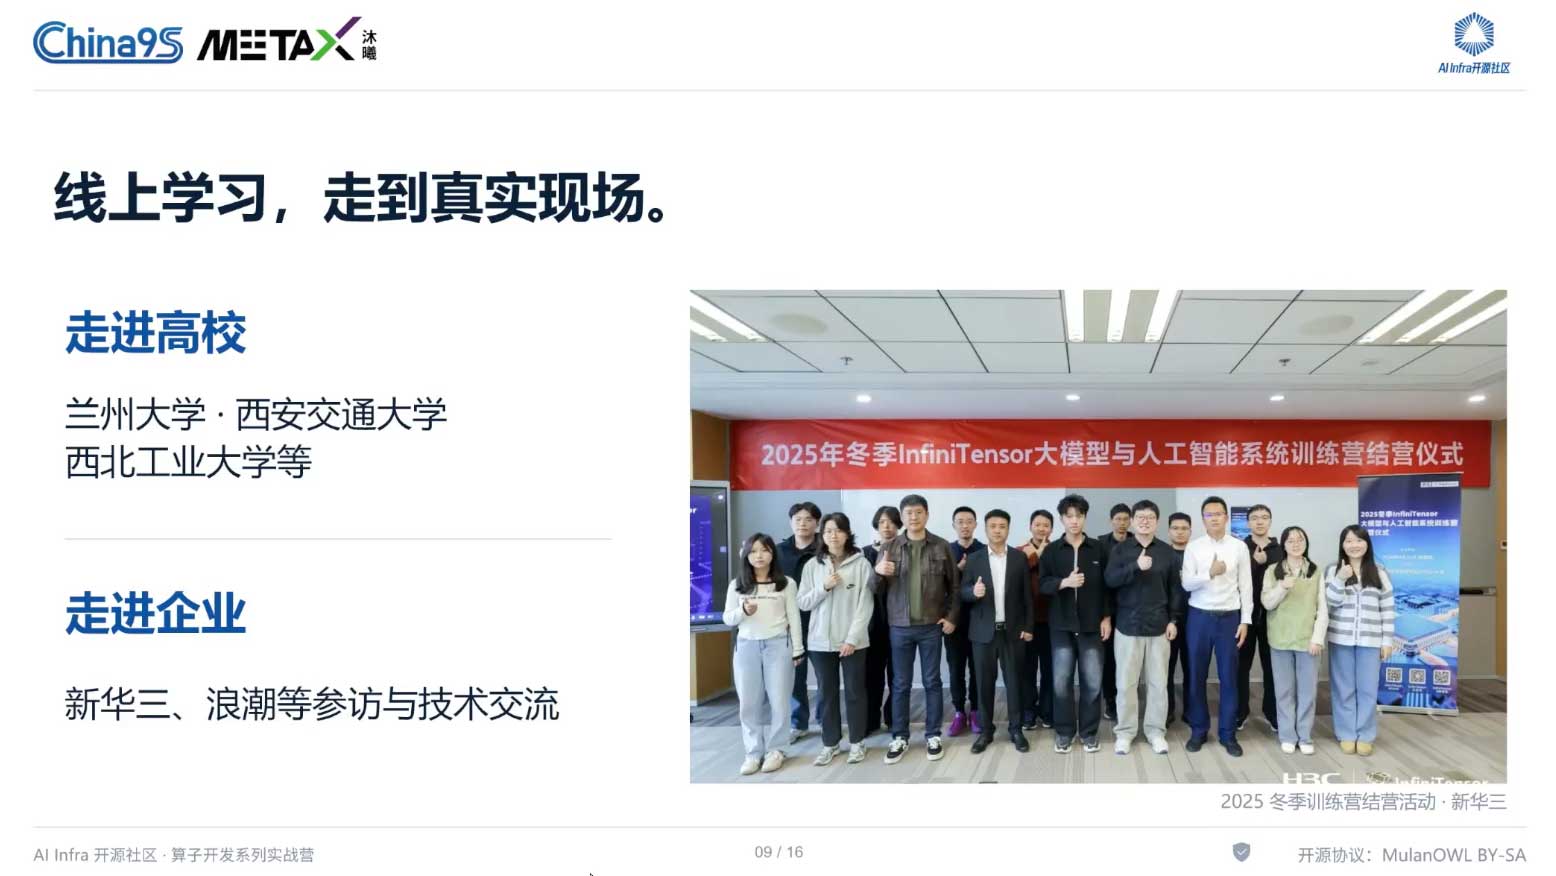
实践与赛事
- 线下走进高校:兰州大学、西安交通大学、西北工业大学等
- 走进企业:组织优秀学员参观新华三等企业
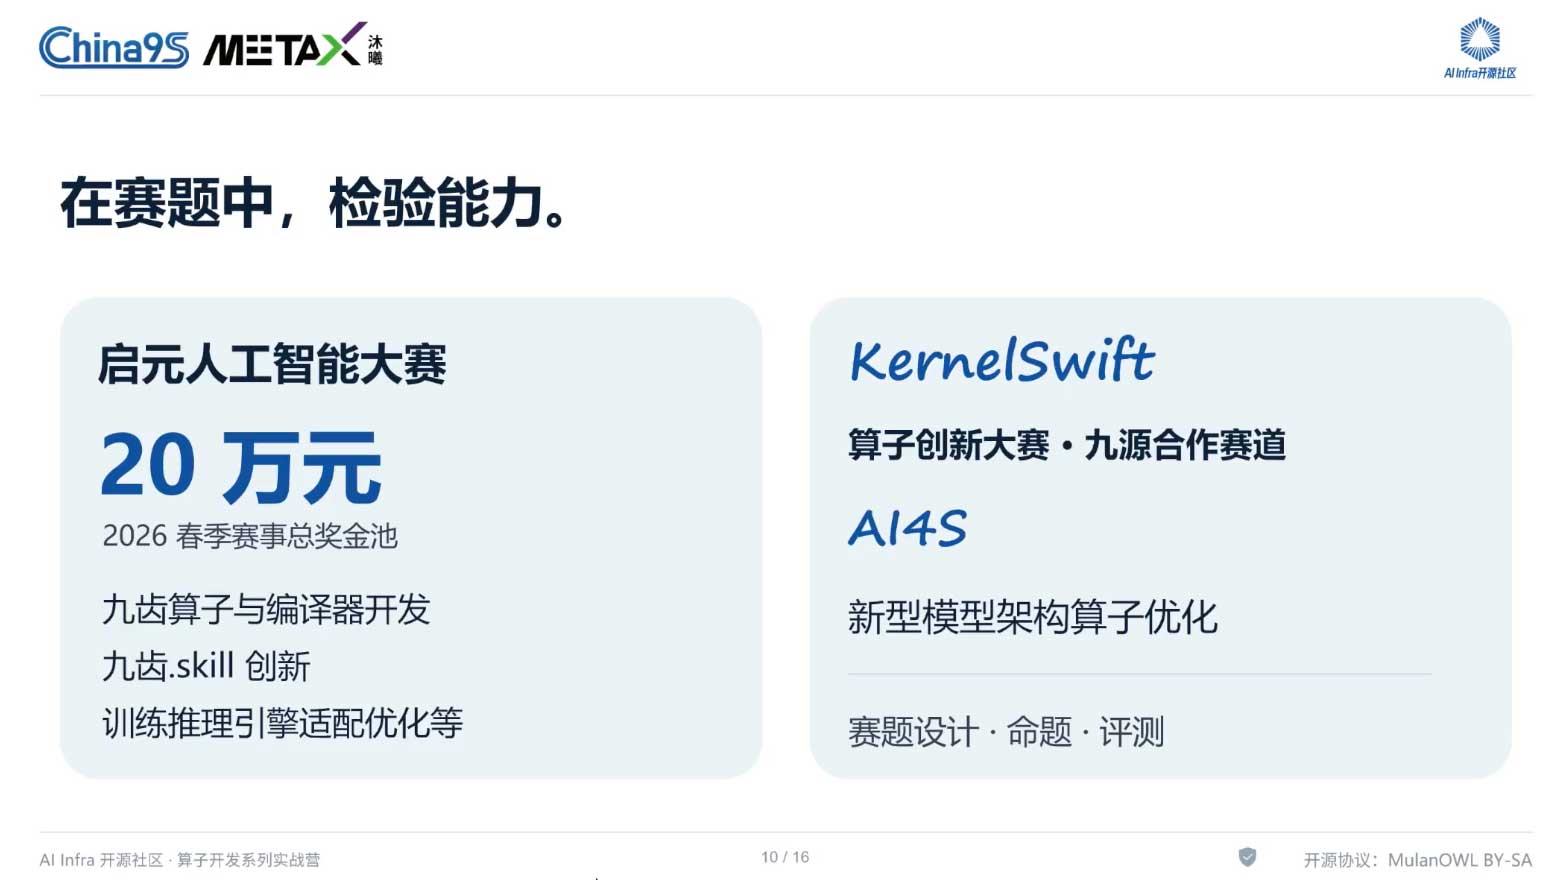
- 启元人工智能大赛:设置九齿算子与编译器开发、推理引擎适配优化等赛道,总奖金池 20 万
- KernelSwift 算子创新大赛:与上海人工智能实验室合作
- 嵩山杯:即将开展独立赛道
对学员的邀请
- 刚入门:从社区基础课程和小作业起步
- 有基础:认真参与实战营后,继续参加项目实践和赛事
- 有经验的工程师:把实际问题带到社区,参与代码贡献和课程共建
- 高校老师:把课程实训和科研需求结合
- 九源为优秀学员提供 实习推荐和企业内推 机会
开营首讲:清华大学王豪杰老师
《九源软件栈核心技术与开源生态》
主讲人:清华大学 / 启元实验室助理研究员王豪杰老师
一、统一架构
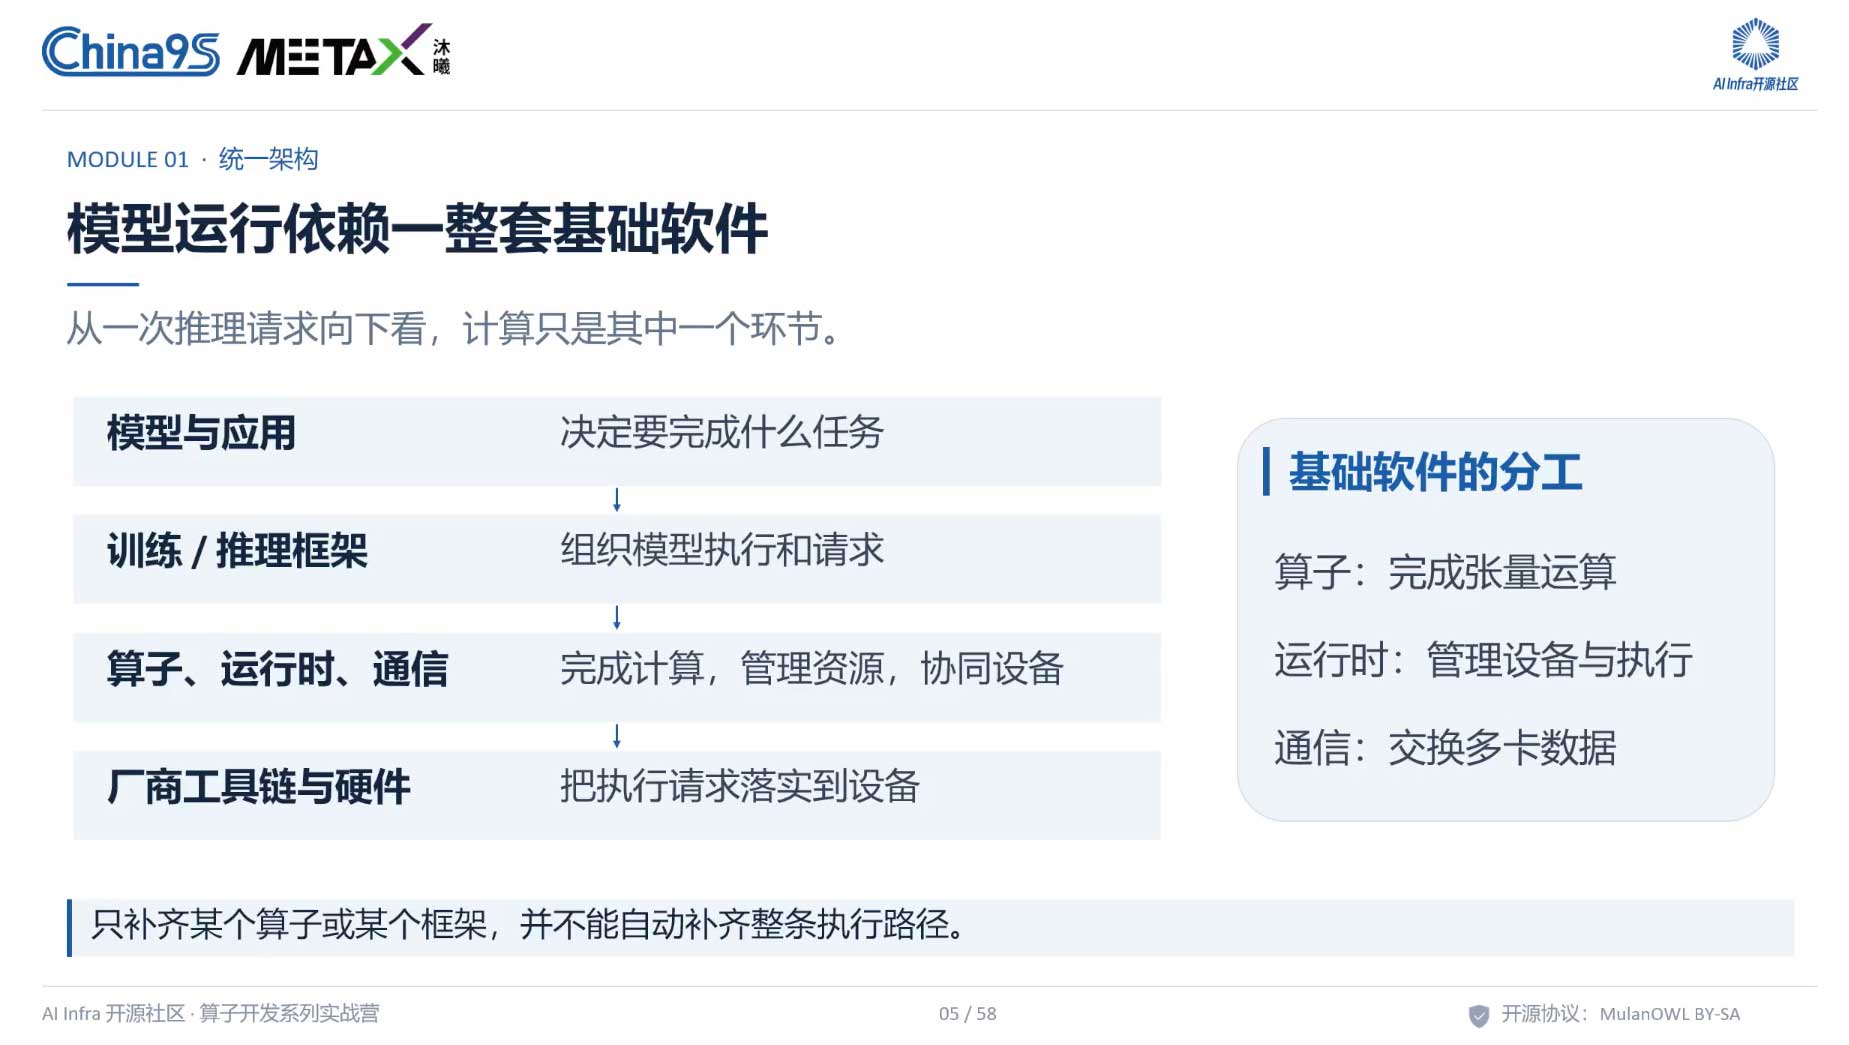
1. 为什么需要统一计算架构
- 核心问题:同一模型迁移到不同国产硬件平台时,需要重写或大量修改软件
- 根本原因:
- 平台差异性:底层 SDK、工具链各不相同
- 各平台的算子库、运行时库、通信库存在差异
- 目标:抹平底层差异性,将共性能力集中到基础软件层次
2. 分层架构设计
3. 硬件能力评估维度
- 计算能力(峰值算力,如 A100 的 312 TFLOPS)
- 内存带宽(单位时间内数据搬运能力)
- 内存容量(显存大小,影响可承载模型规模和上下文长度)
- 互联能力(机内多卡、跨机多节点数据交换)
不同工作负载依赖不同能力:
Prefill 阶段看重计算能力,
Decode 阶段看重内存带宽。
4. 九源核心设计目标
- 统一运行: 一套代码在不同硬件平台无需修改即可运行
- 高效执行: 发挥加速卡该有的性能,保留硬件优化和异构协作能力
- 持续演进: 支持模型、硬件、工具的持续更新,模块化扩展
5. 九源软件栈
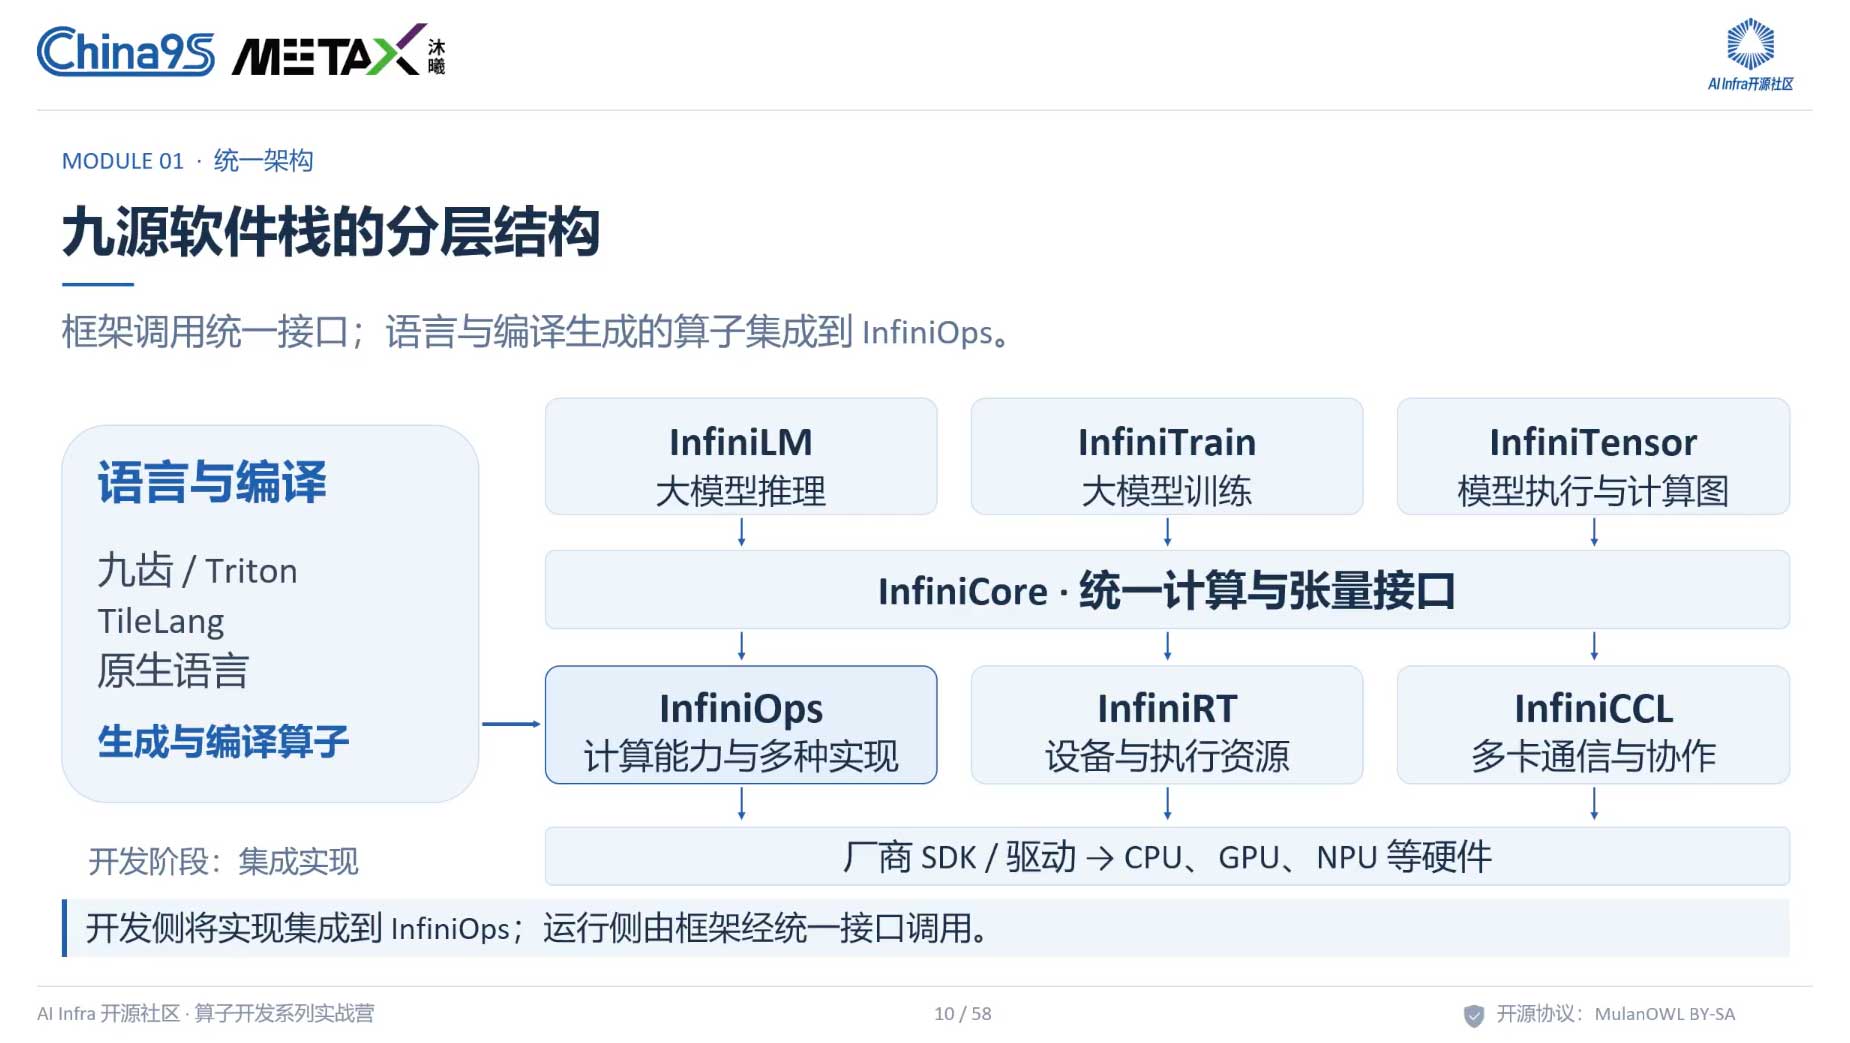
- 跨平台运行:同一套模型代码在不同平台保持一致调用和优化方式
- 异构协同:不同加速卡分别承担同一服务中的不同工作,发挥各自性能长处
二、算子与编译
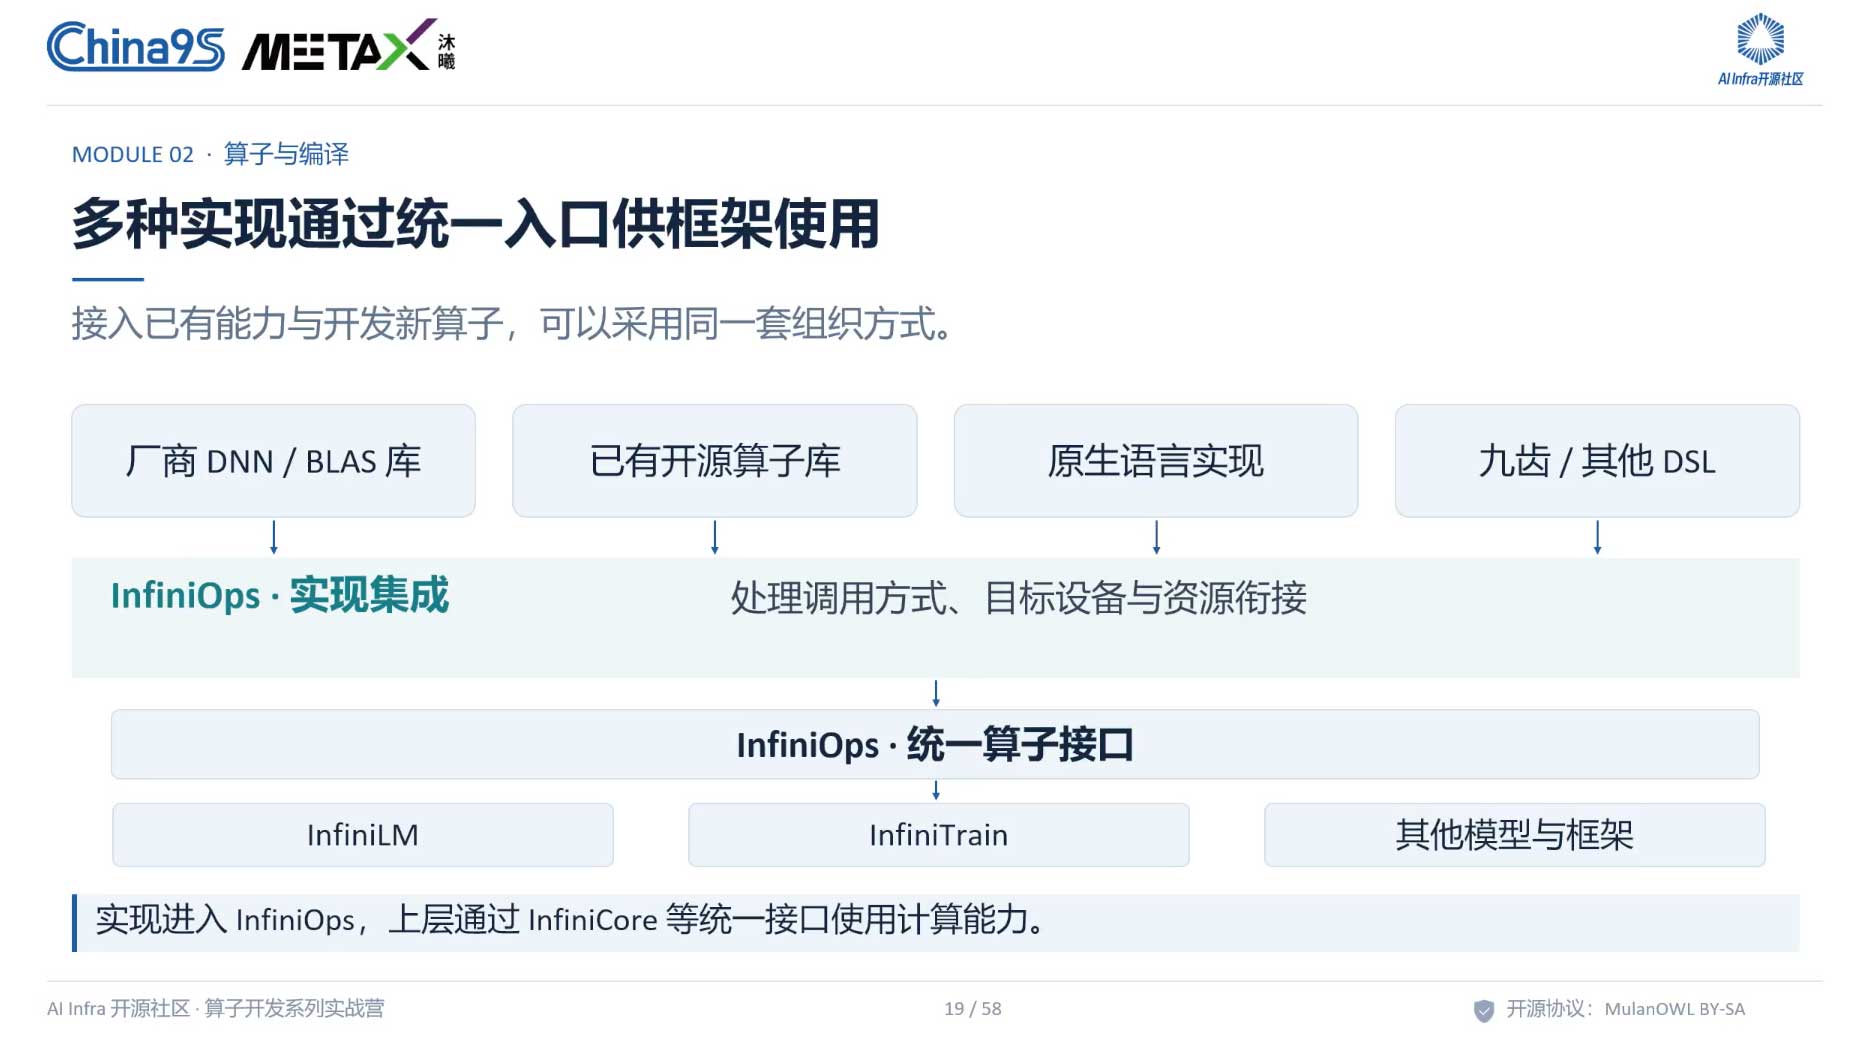
1. 统一算子库要解决的问题
- 算子来源多样:厂商优化库(cuBLAS/cuDNN)、开源库(Flash Attention)、DSL 自定义实现
- 需要抹平三类差异:
- 计算接口差异:输入方式、参数、数据类型
- 执行资源差异:设备管理、内存管理、任务提交方式
- 能力覆盖差异:输入范围、stride 支持等
2. 统一算子库执行流程
- DSL 算子:源程序 → 编译/调优/缓存 → 运行时 JIT 编译 → 算子加载 → 执行
- 厂商算子库/原生语言算子:明确计算语义和调用接口 → 统一对接
- 上层框架无需关心底层实现方式,统一调用即可
3. 统一算子库三大核心目标
- 选优: 针对特定硬件和场景,自动找到最优实现
- 扩展: 新模型需求可通过 DSL 快速补充算子,无需关心工具链配置
- 裁剪: 根据实际部署需求定制化裁剪算子库,节省运行时资源
4. 九齿(NineToothed)编程语言
- 设计动机:
- 降低描述计算和组织并行的门槛
- 核心思想:
- 数据编排(Arrangement):定义数据分块方式(行分块、列分块、输出块映射)
- 局部计算(Application):以串行语义描述计算(置零 → 沿 K 累加 → 反写)
- 编译器自动完成并行化映射(花 20% 精力达到 80%+ 性能)
- 编译模式:
- AOT:运行前预编译,形成预加载库
- JIT:运行时按需编译
三、运行时与通信
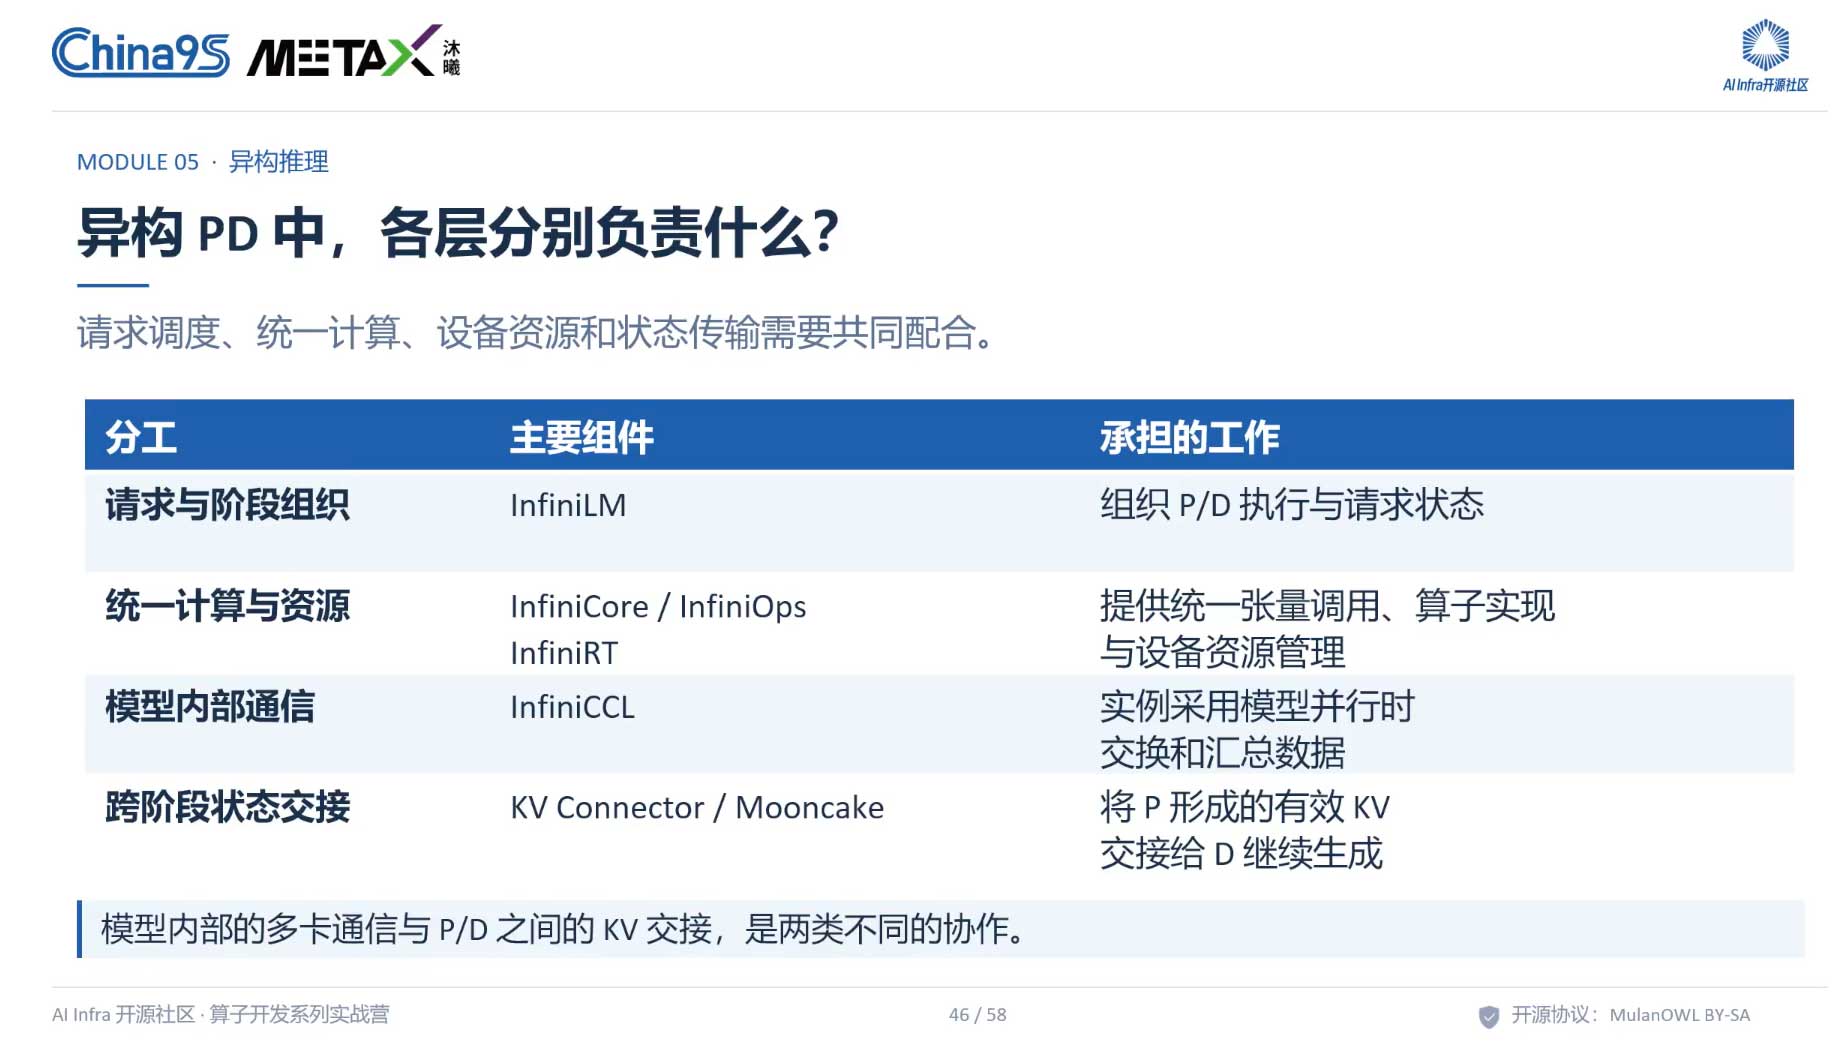
1. 运行时(InfiniRT)
- 核心职责:设备管理、资源管理、任务调度、依赖管理
- 执行流程:准备资源 → 提交任务 → 按依赖执行 → 资源复用/回收
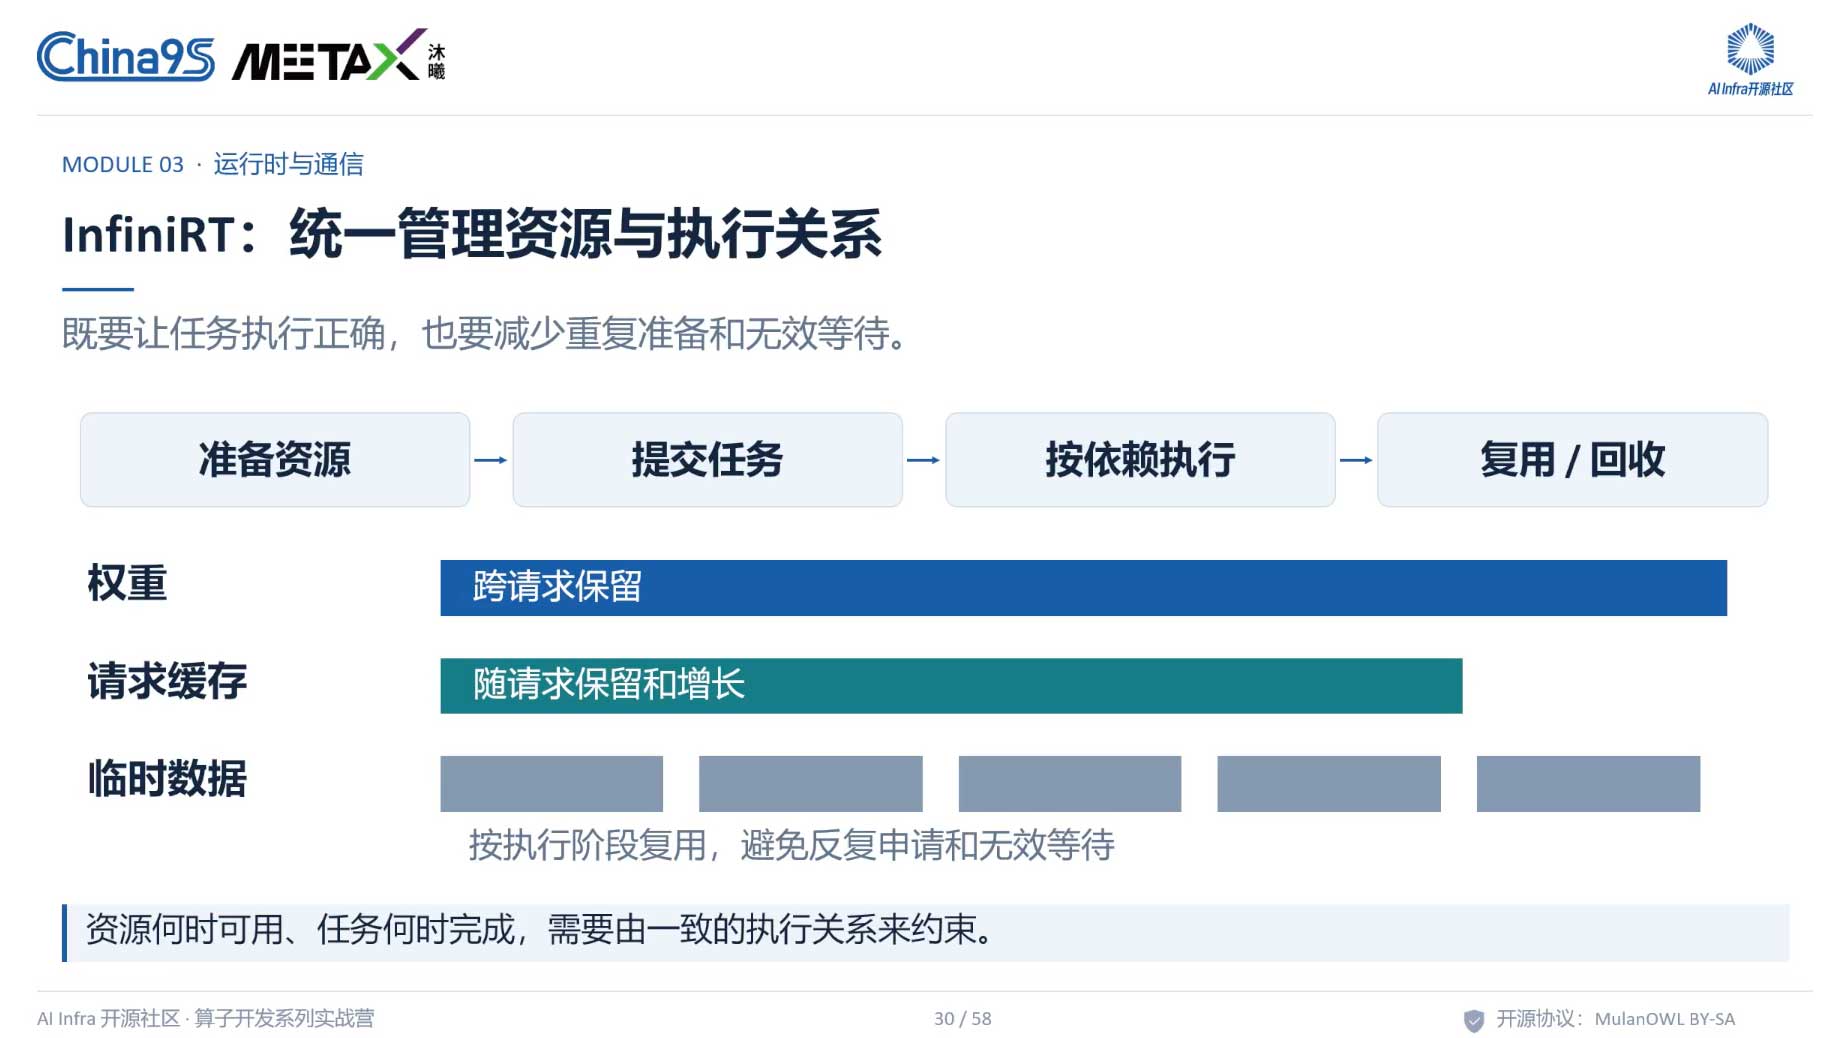
- 资源分类管理:
- 权重:定长,跨请求复用保留
- 请求缓存(KV Cache):随请求增长,需管理内存不足策略
- 临时数据:工作空间,用完即释放,需判断复用还是重新申请
2. 通信库(InfiniCCL)
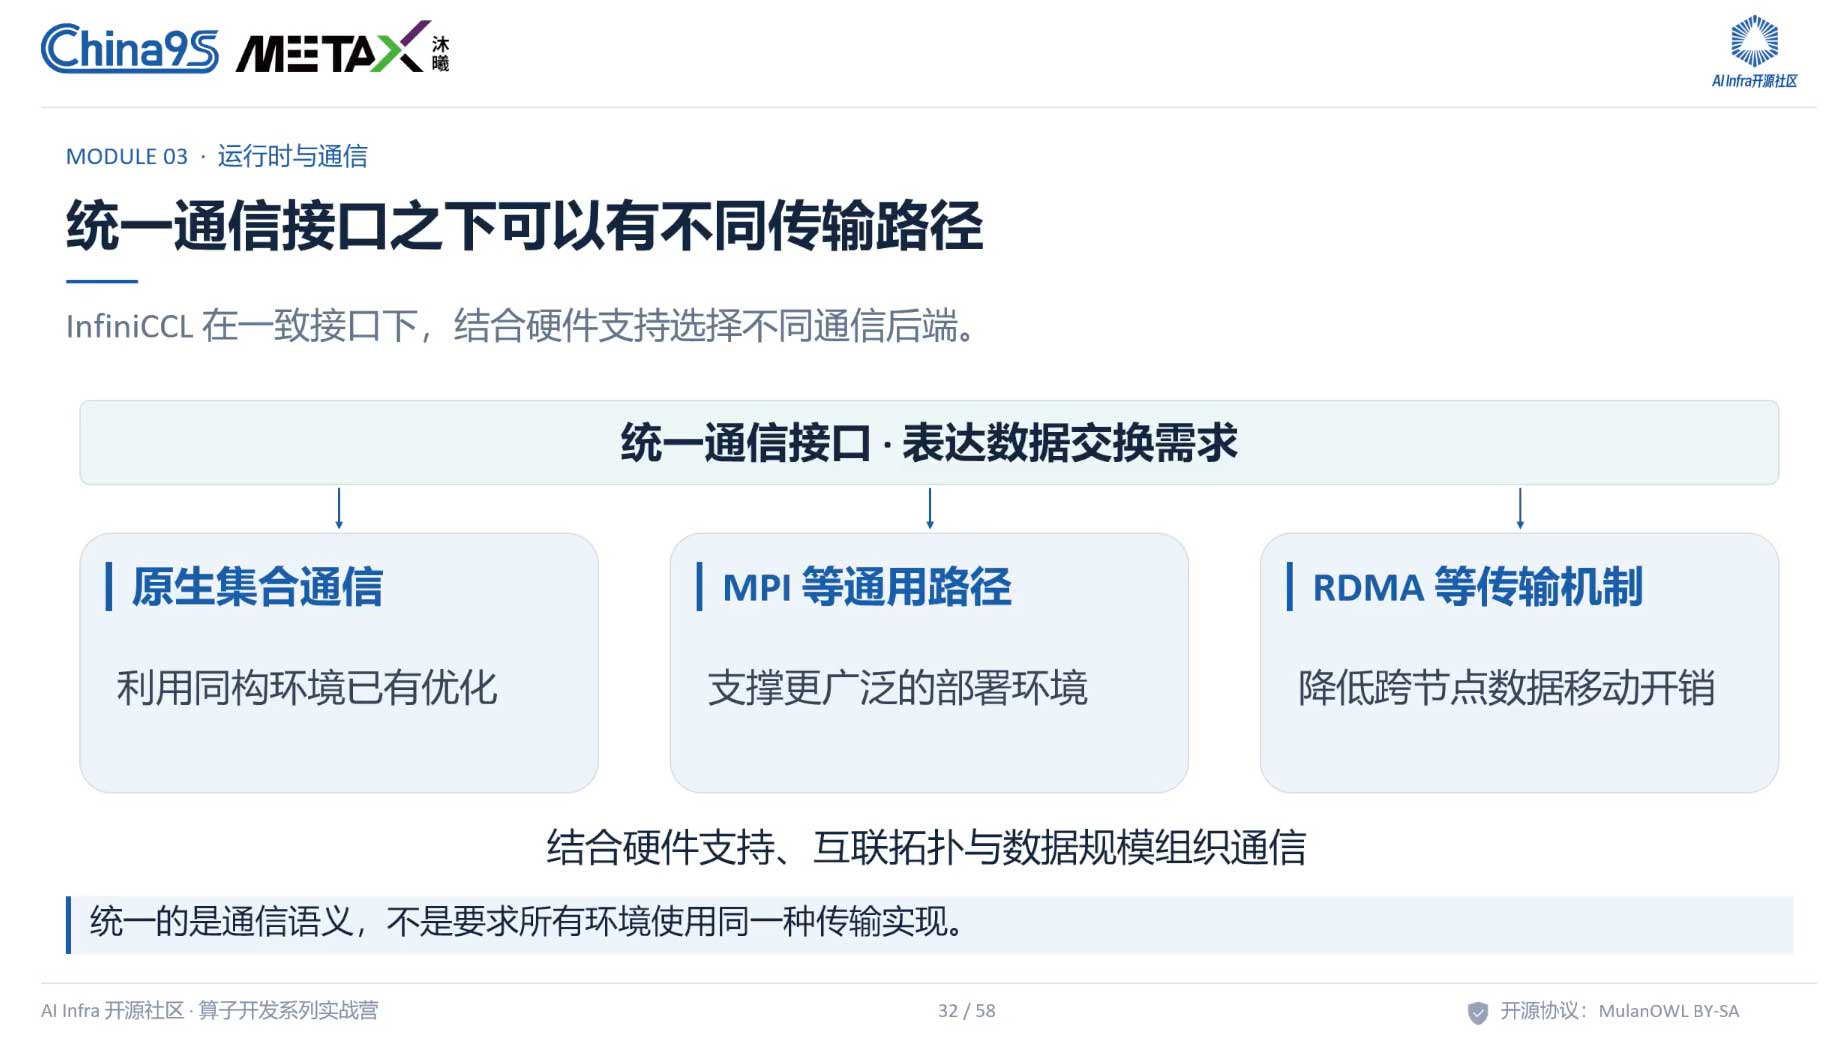
- 统一接口:上层只关心数据的逻辑汇总和分发,底层自动选择最优通信路径
- 通信路径:
- 同构环境:原生集合通信(如 NCCL 及沐曦对等库)
- 异构环境:回退到 MPI 通用路径
- 跨机传输:尽量利用 RDMA 减少数据移动开销
- 自动分析:根据数据交换需求和硬件拓扑,自动找到最优通信实现
四、推理框架(InfiniLM)
1. 推理引擎的职责
- 请求接收与排队
- 模型与缓存管理
- 计算资源服务多个请求的调度
- 贯穿多轮执行的完整循环
2. 推理两阶段模型
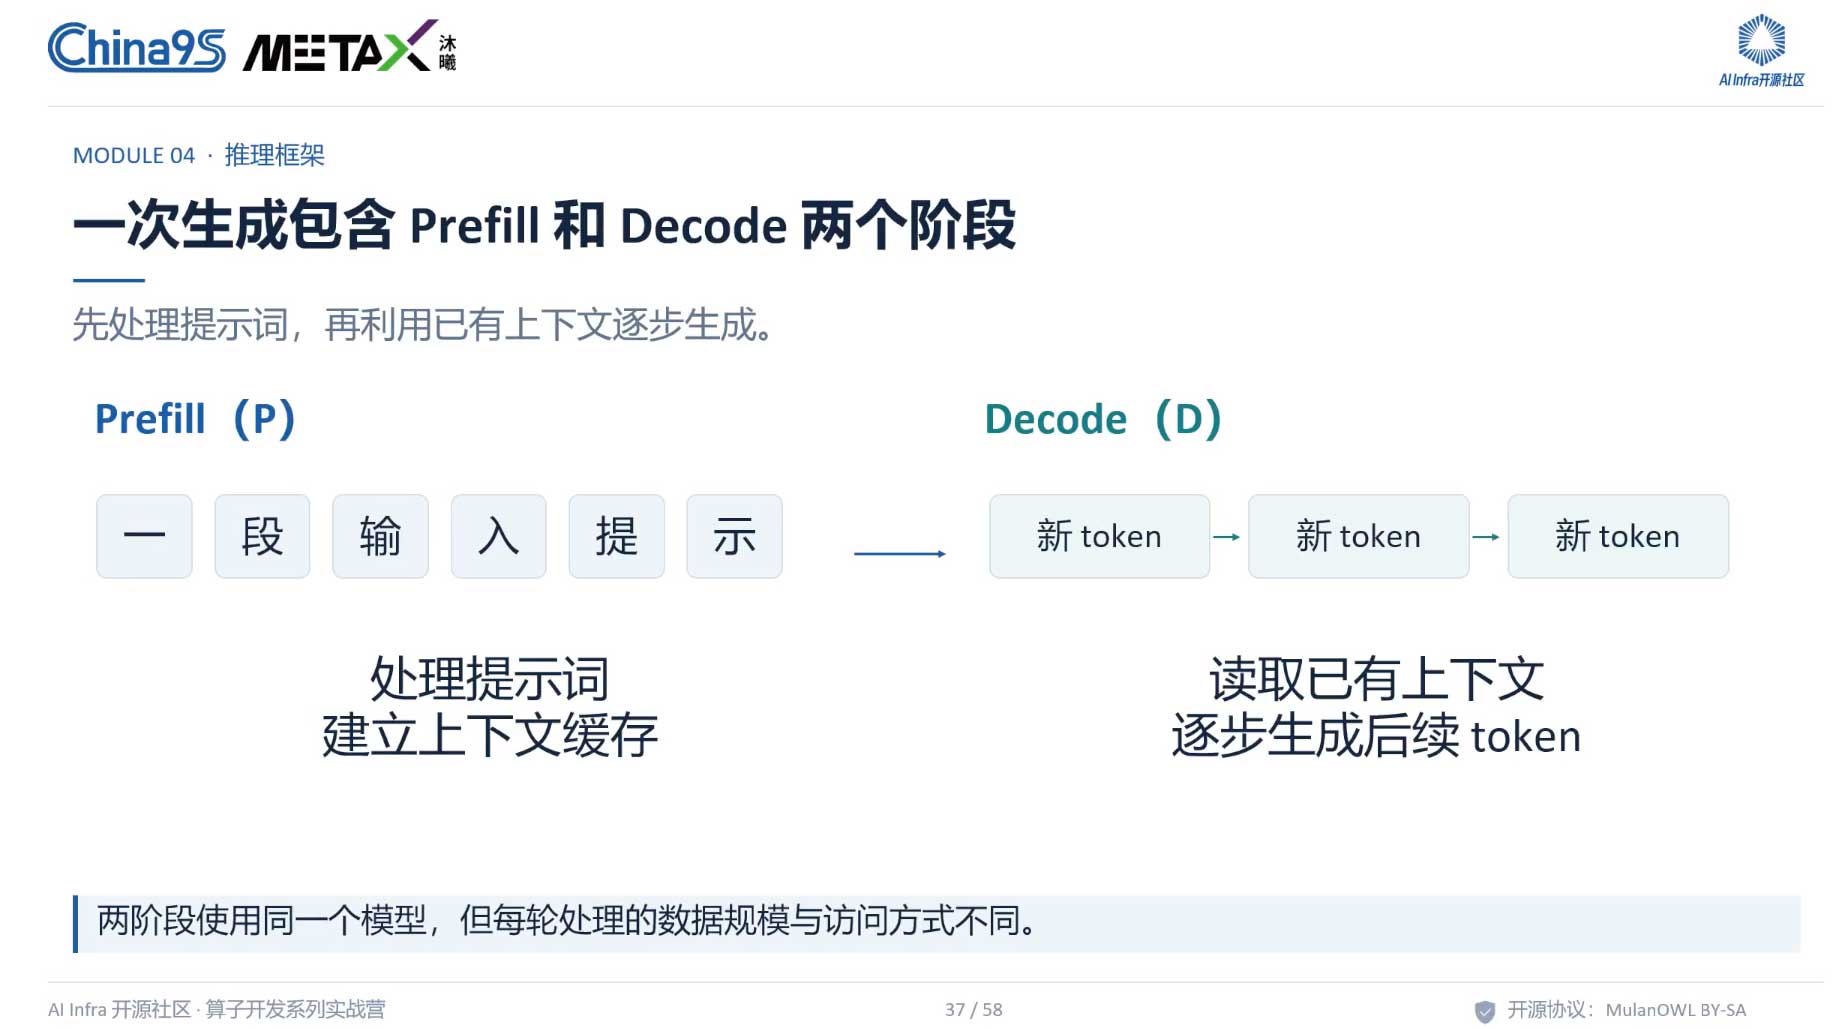
- Prefill :compute-bound,关注峰值算力,服务指标常用 TTFT
- Decode:memory-bound,关注显存带宽,服务指标常用 ITL
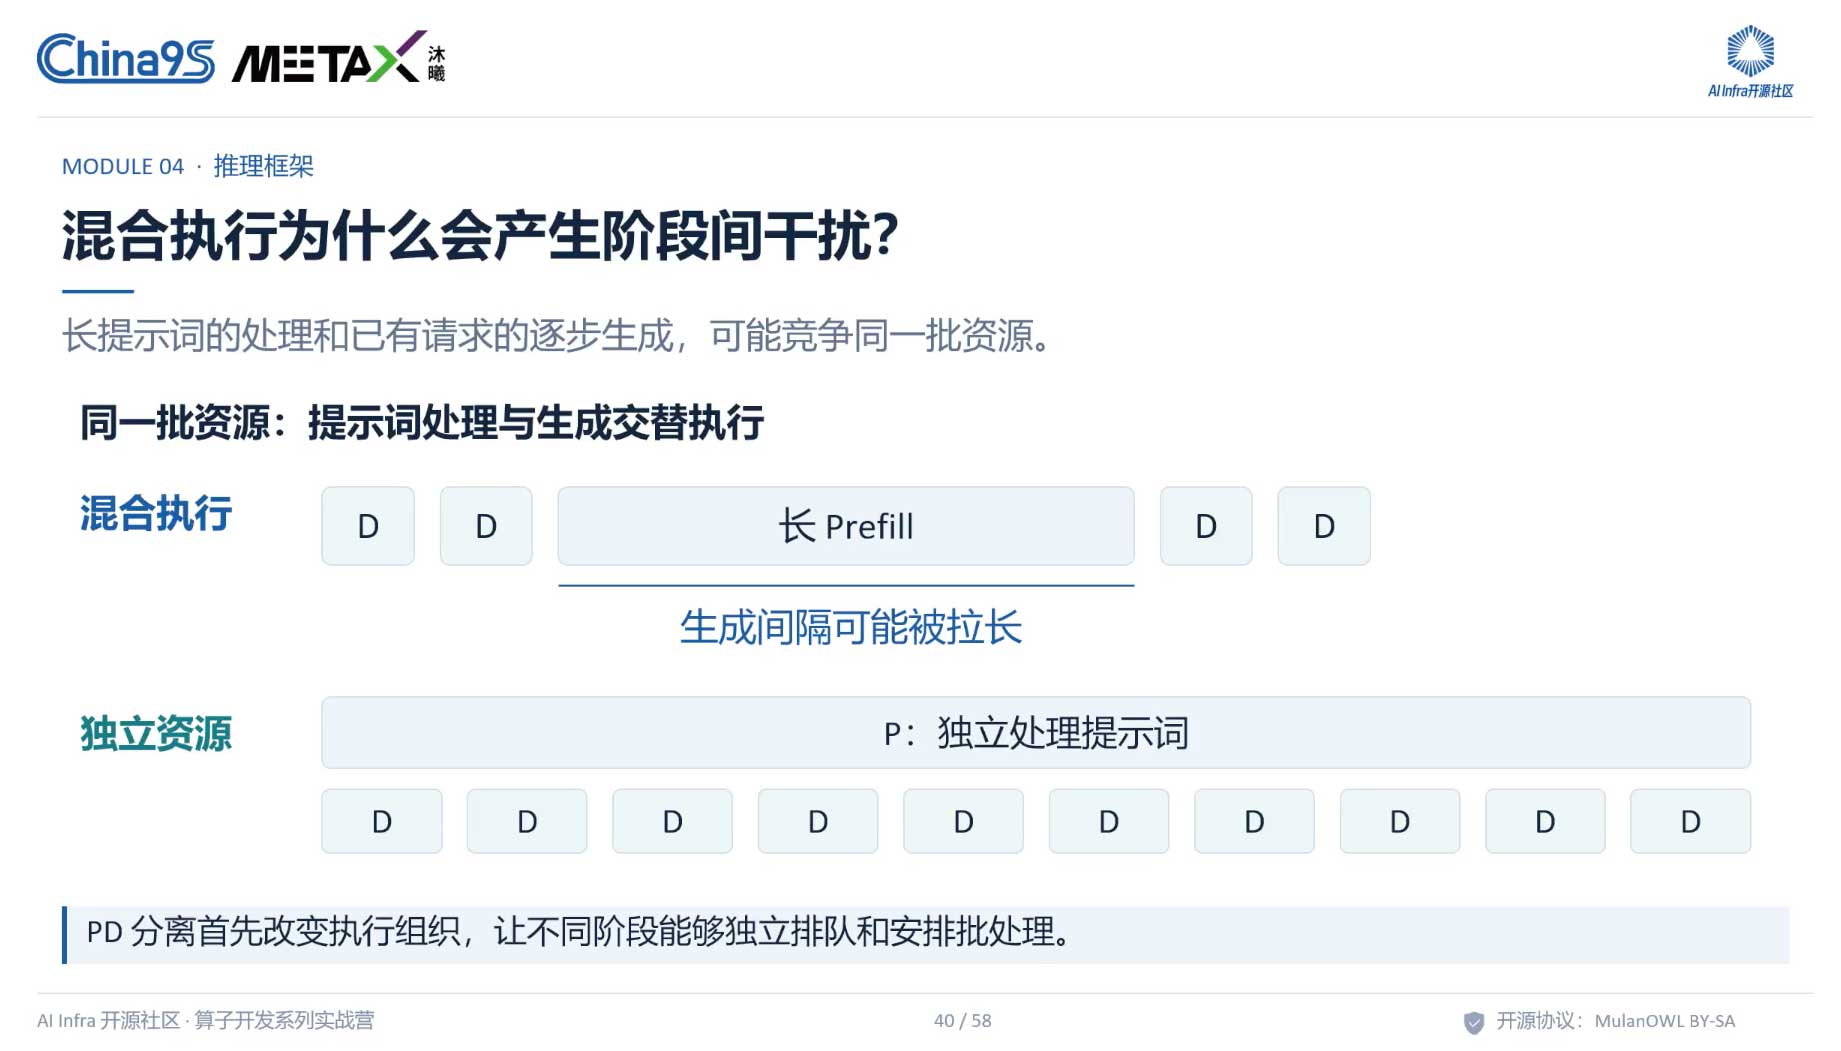
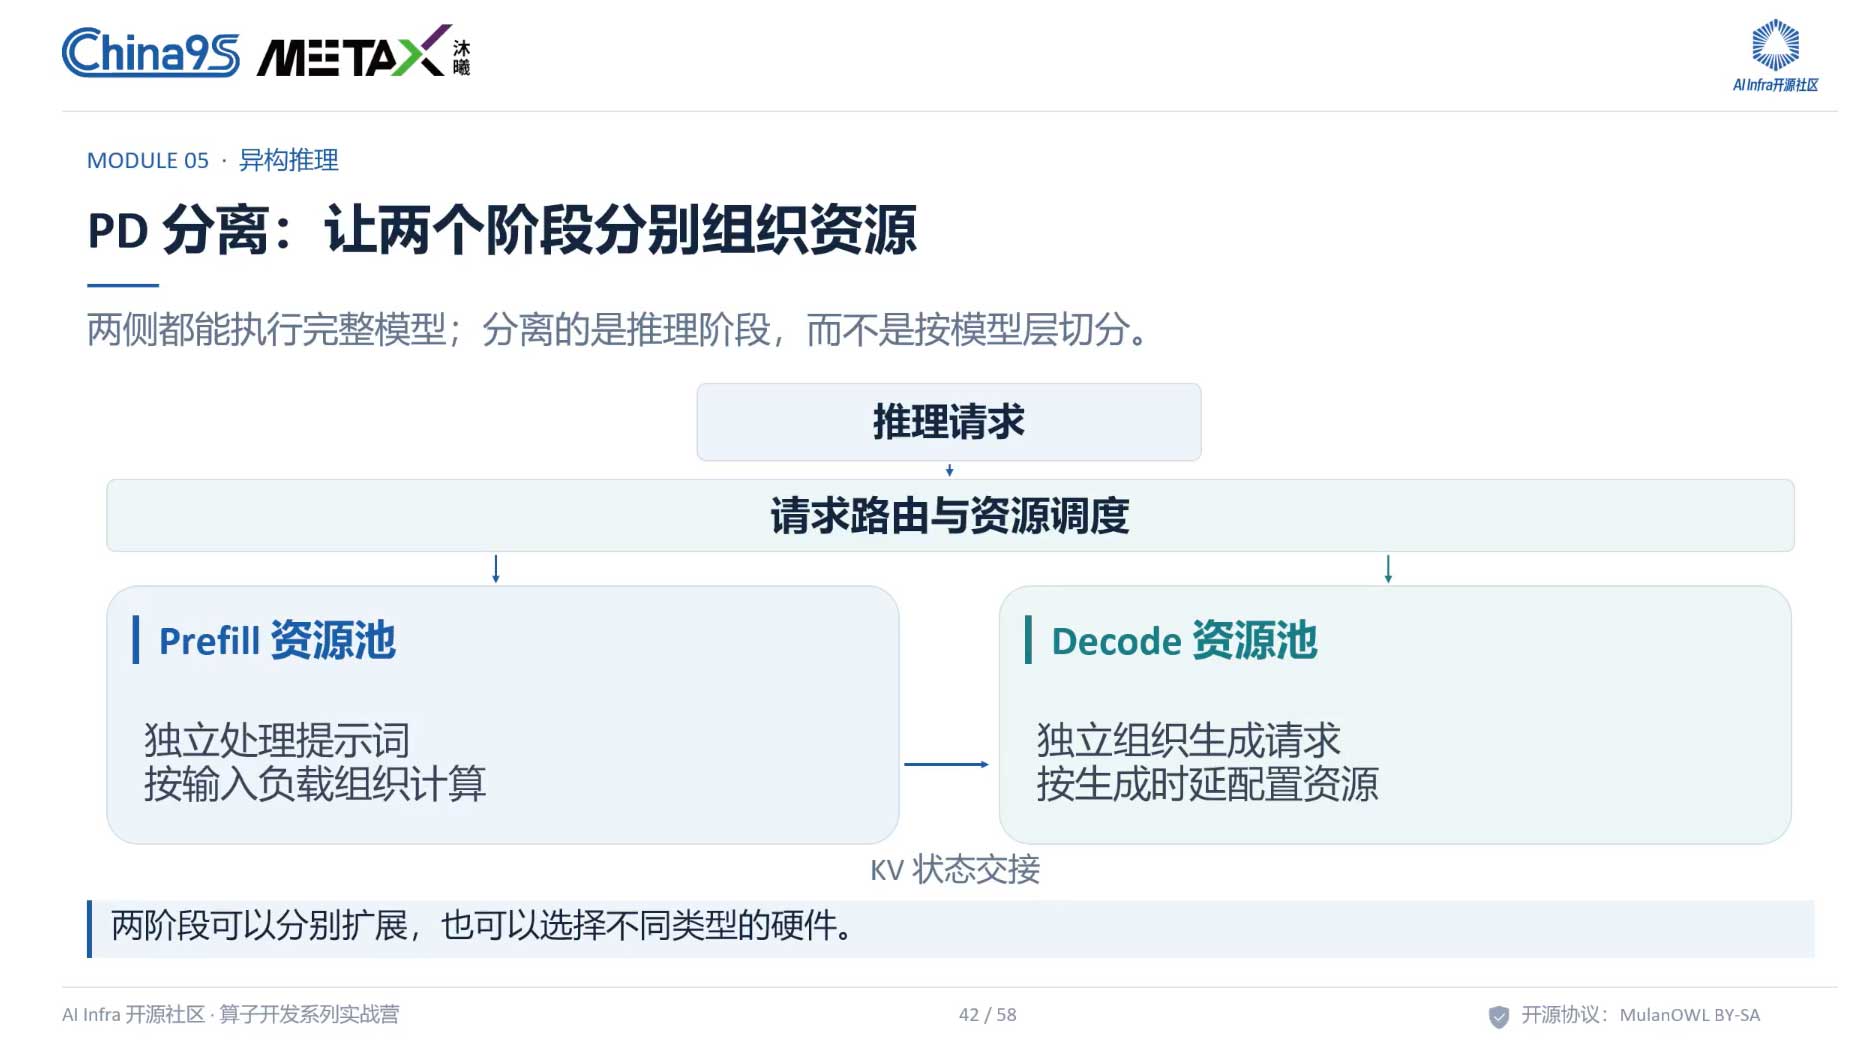
3. P/D 分离策略
- 将 Prefill 和 Decode 划分为独立的请求池和资源池
- 避免 Prefill 插入 Decode 过程导致 ITL 被拉长
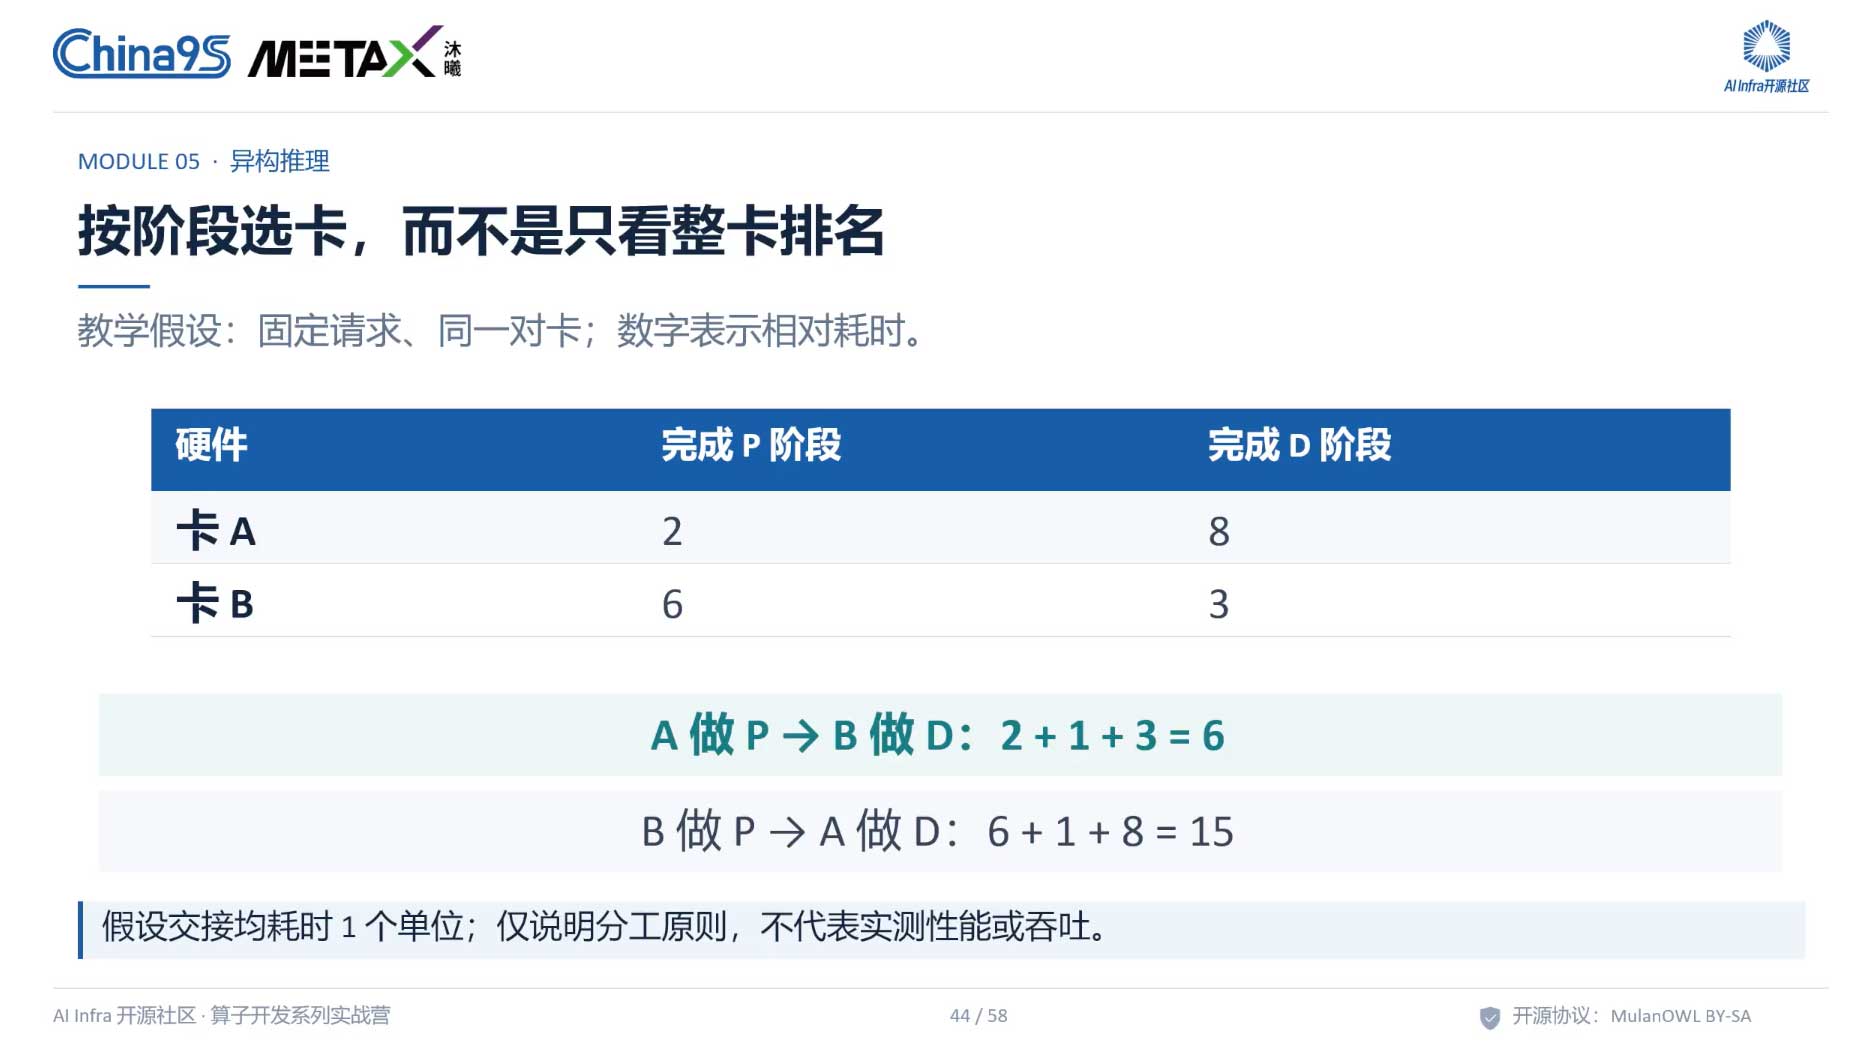
- 不同硬件按性能特征分配:高算力卡 → Prefill,高带宽卡 → Decode
五、异构推理与 PD 分离
1. 异构 PD 分离原理
2. 异构 PD 分离的收益
3. 实验及结果
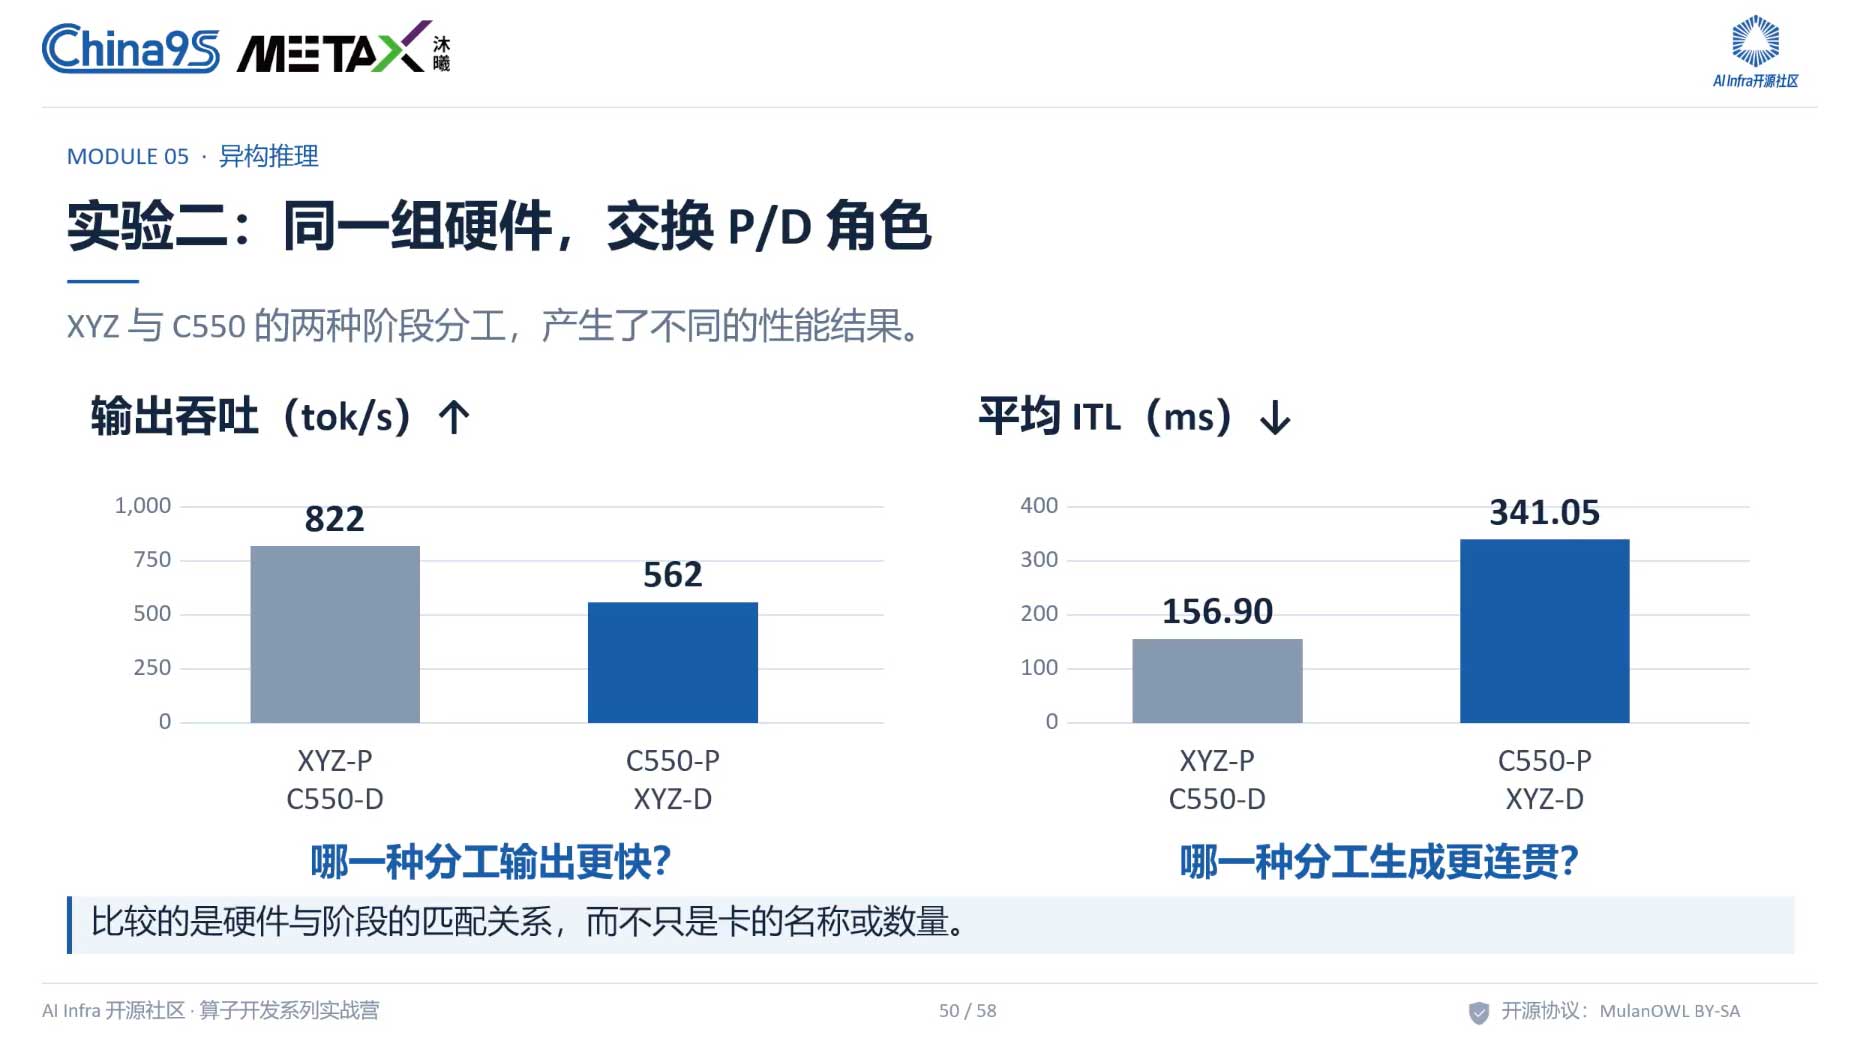
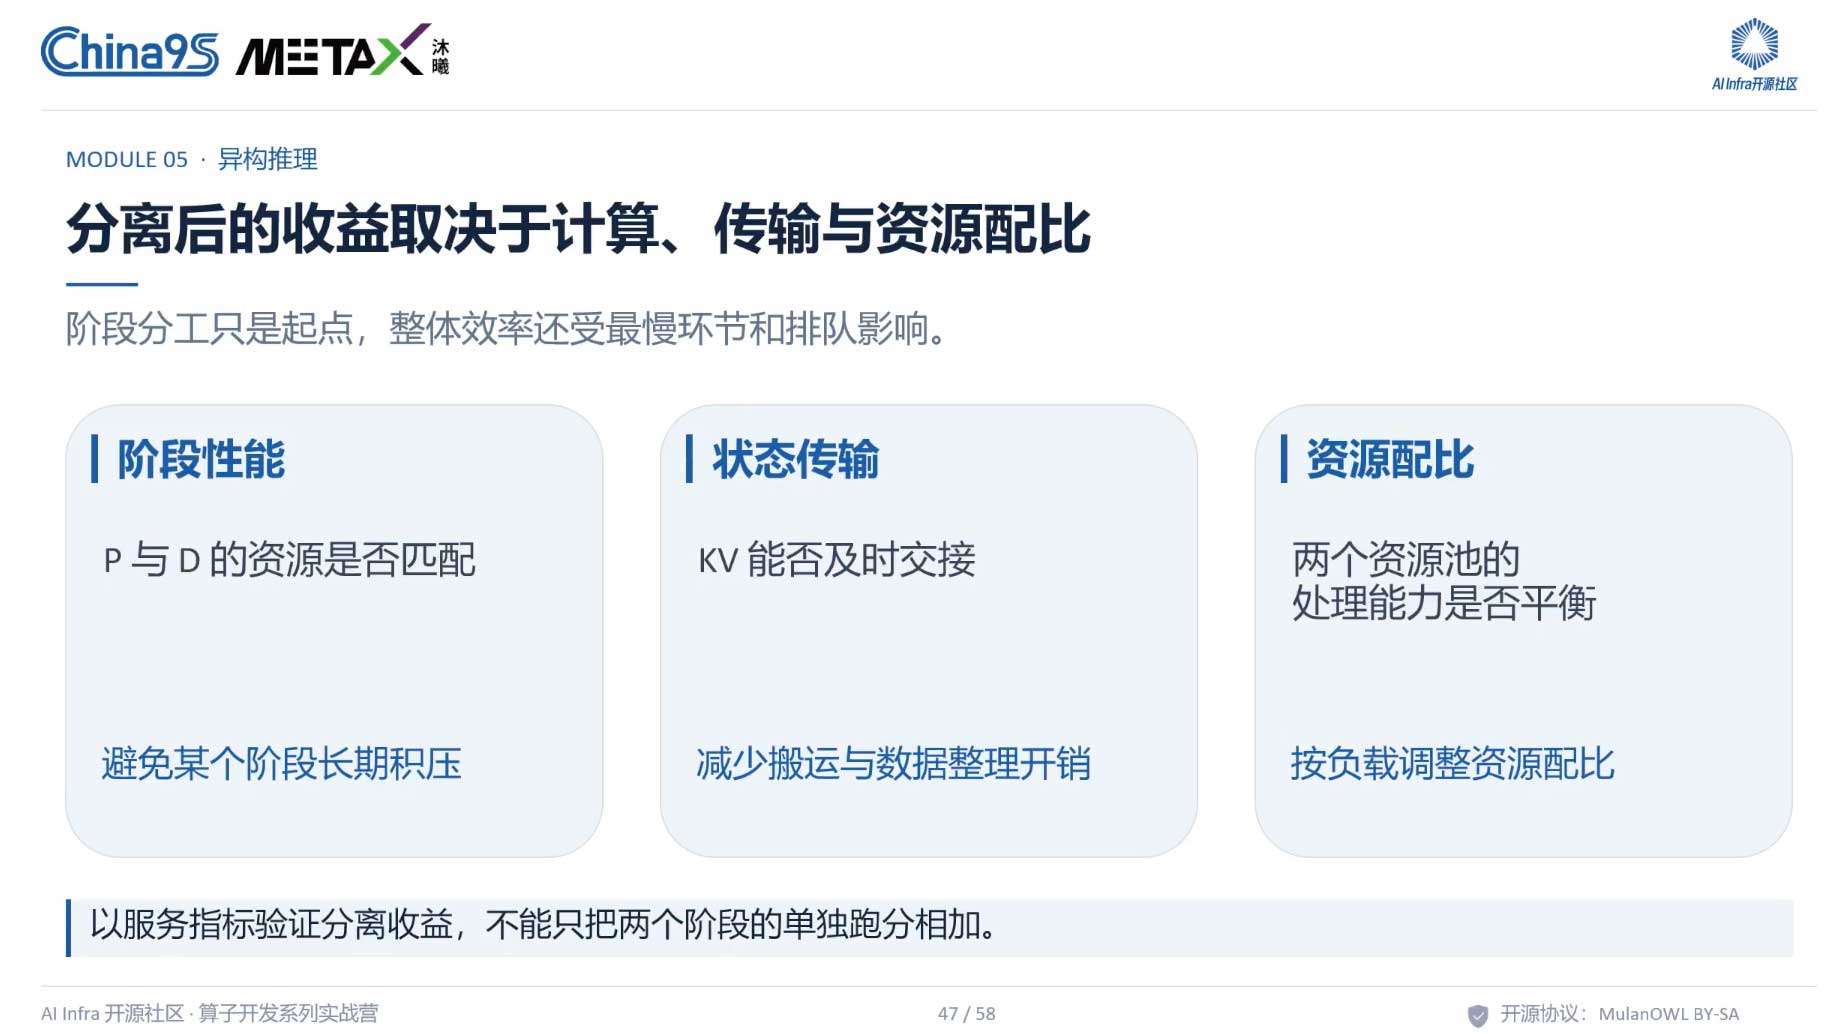
4. 关键影响因素
- P/D 资源配比是否平衡
- KV Cache 交接效率(网络带宽:RDMA > CPU 中转 RDMA > TCP/IP)
- 动态切换能力:根据线上负载变化调整 P/D 资源分配
六、开源共建
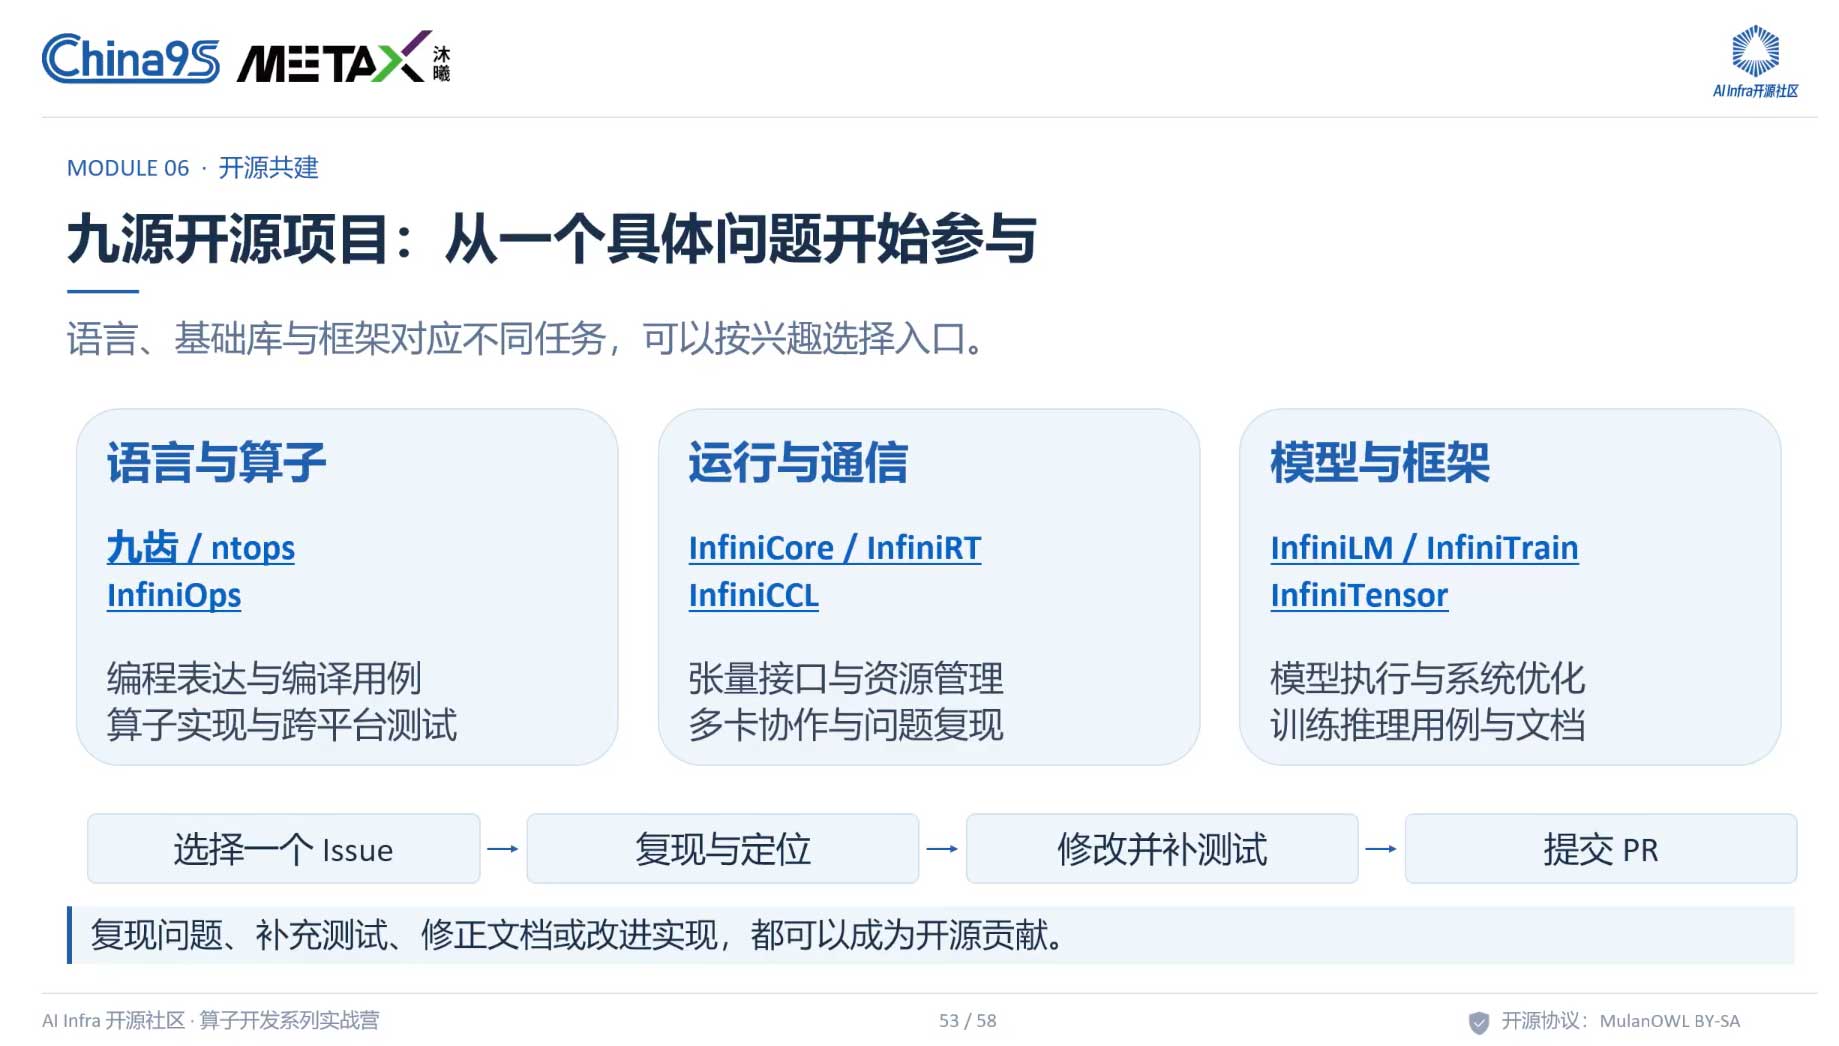
1. InfiniTensor 开源项目
2. 学习与实践资源
- 基础课程:C++、Python、并行编程基础
- 方向课程:算子与编译、训练、推理、通信
- 练习项目(千行代码规模):
TinyInfiniTensor(AI 编译器方向)llaisys(大模型推理方向)TinyInfiniTrain(训练框架方向)GoLlamaGo(沐曦实战营项目)
3. 参与方式
- 提出/复现/定位 Issue → 修改代码 → 补充测试 → 提交 PR
- 参与赛事:启元人工智能大赛、KernelSwift 算子创新大赛、嵩山杯
- 文档改进、评测贡献、课程共建均欢迎
关注与交流